【AI】大模型LoRA微调和参数训练的原理分析(未完成)
todo 简单介绍 本来想一篇文章介绍 LoRA微调和参数训练的原理,在加上实验验证。但是没想到原理的介绍越来越长,因此还是分开文章说吧。
前置数学基础
人工智能相关算法中,包含很多的数学知识,其中更是包含大量矩阵操作。虽然上学的时候学过,但已经忘了不少。因此这里再简单复习一下下文中会用到的一些数学知识。
矩阵乘法
一个M×N的矩阵
矩阵和矩阵之间可以进行运算,其中矩阵加法就是要求矩阵行列相同每个元素相加,矩阵相乘则麻烦一点。两个矩阵相乘,要求左边矩阵的列数等于右边矩阵的行数,形如:
因此,矩阵相乘不满足交换律,因为换之后中间的行列数可能不相等,即使相等,计算结果也不同;但满足结合律,即计算括号可以重新组合。
向量可以看作是一个特殊的矩阵,即行或者列为1。下面列举几种矩阵相乘的特殊场景。首先是矩阵乘向量,结果为另一个向量:
然后是向量乘向量,结果有两种,如果左边一行形式向量乘右边一列形式的向量,则结果为一个数字。如果反过来,则是一个矩阵。
对角矩阵指的是当矩阵的元素中行坐标和列坐标相等时才有元素值,其余都为0。这里展示一下普通矩阵乘对角矩阵的效果,可以看到相当于给列元素增加了一个系数。
矩阵的秩
首先介绍一下矩阵的初等变换。矩阵的初等变换有行变换和列变换,规则是一致的,这里以行变换说明。以下几种变换是初等行变换:
- 交换任意两行的位置
- 非0的常数乘任意一行
- 把任意一行乘以非0常数,加到另一行上面
如果一个矩阵经过任意数量的初等变换之后,尽量将矩阵中的行(或者列)变为全0。剩下的无法变化的行数(或列数)就是矩阵的秩。如何可以变为全0?如果一行是其它行的倍数,或者可以被其它多个行经过倍数和加减表示,那么这一行就可以变为0。
例如下面的例子,第二行是第一行的两倍,那么第二行=第一行*2,第四行=第一行+第三行,那么第二行和第四行都可以经过初等行变换处理为全0行。
剩下无法被其它向量表示的向量,都是线性无关的,这些线性无关的向量个数即是矩阵的秩。从信息论的角度来说,这些可以被其它向量表示的向量,是不增加信息量的,它自身没有存在价值,属于冗余参数。
对数
首先看一下对数的概念。如果a的y次方为x,那么y就是以a为底的x的对数。其中a>0且a≠1。其中自然对数In(x)是以e为底的对数。e是一个无理数,值为e=2.71828...。
对数满足一些特殊的运算性质:
再简单提一下指数的运算性质:
对数相关的求导公式:
当a的范围在0到1之间时,与a>1时,对应
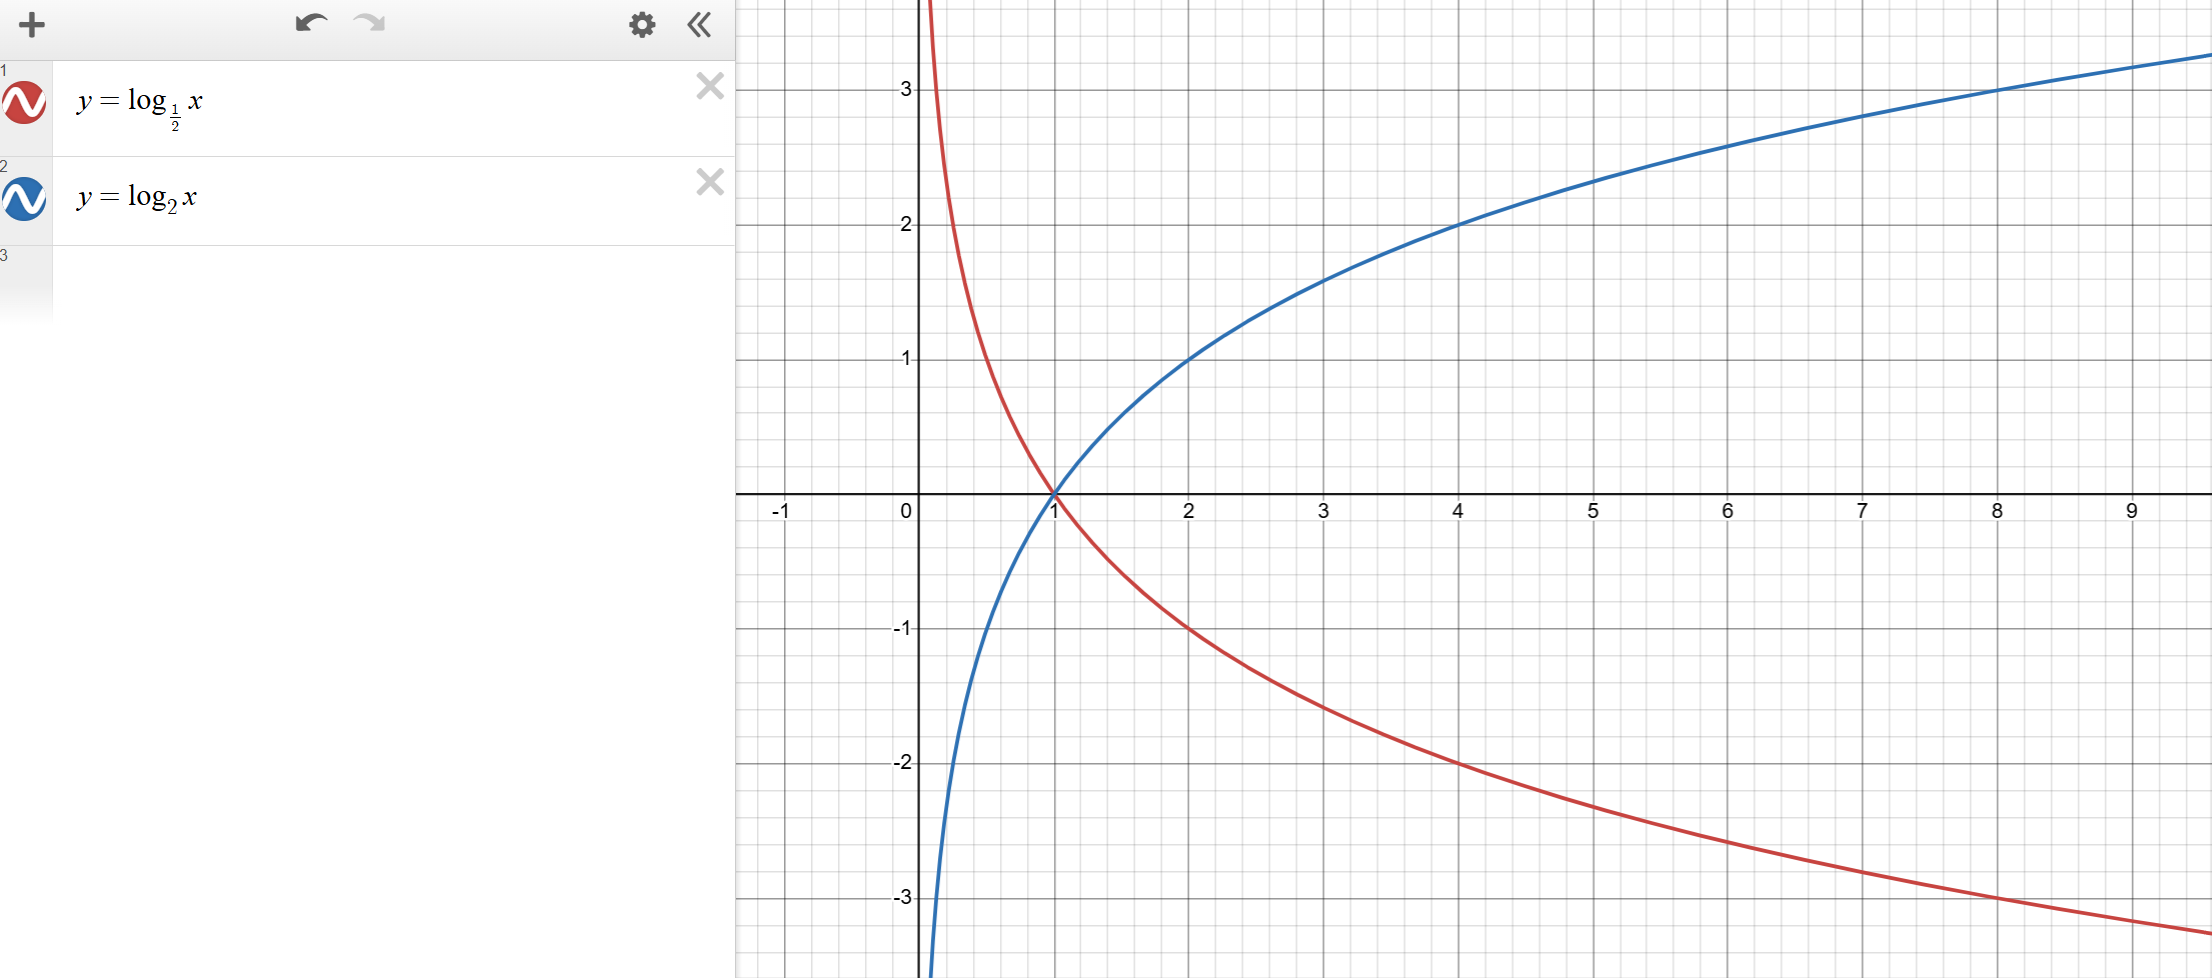
特别的,
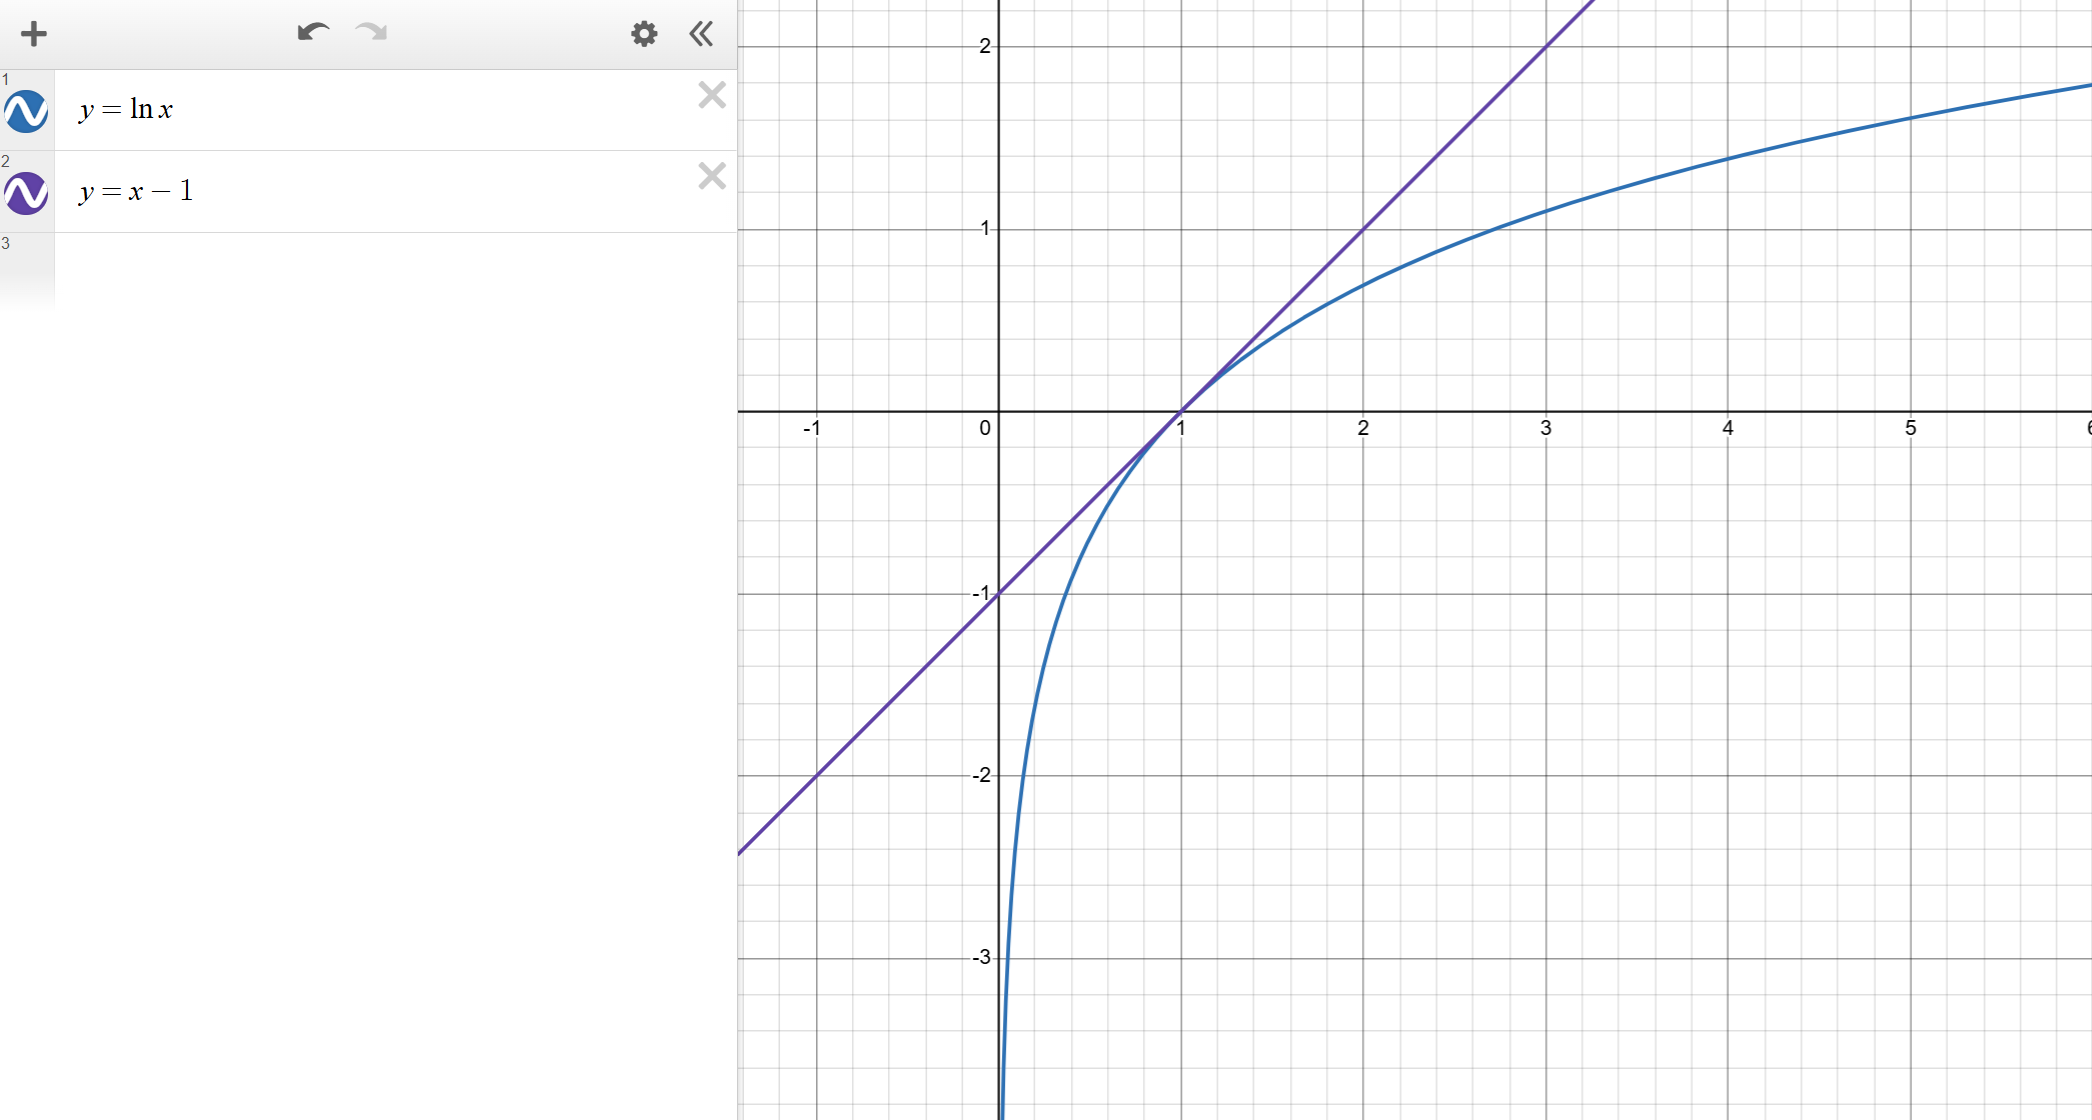
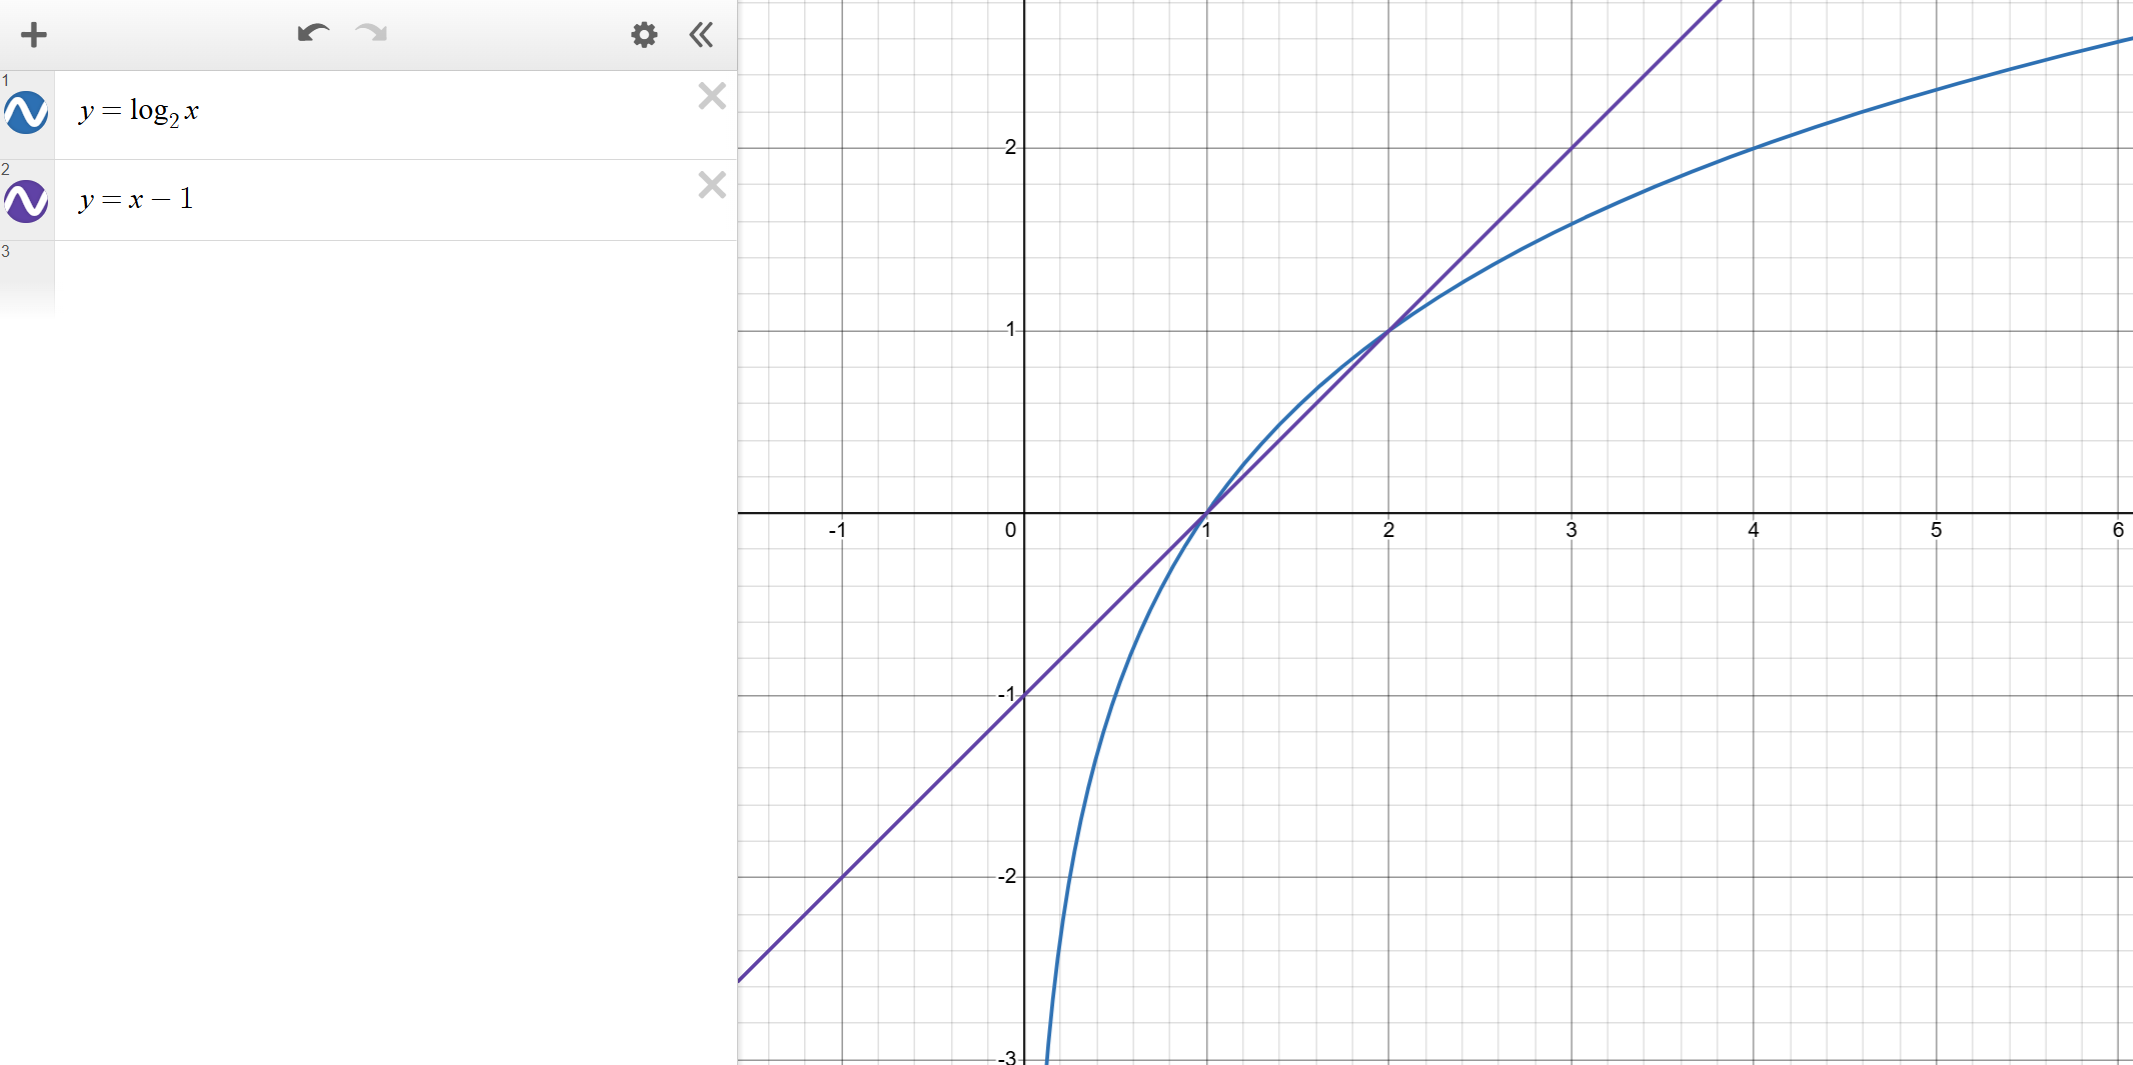
但是对于其它底数,这个不等式却不一定成立。例如
偏导数
首先来复习一下导数的概念。函数的导数也是一个函数,指的是函数在某一点的变化率,也可以被称作斜率。用极限公式表示如下:
当一个函数的变量有多个时,如果想求这个函数对其中一个变量的导数,那这就是偏导数。
如何求偏导数的值呢?实际上和普通的求导方式一致,即把当前求导的变量看做变量,而把其它变量看作常数即可。这里举个简单的例子:
从几何意义上来说,假设z=f(x,y)是一个三位曲面,则对x求偏导相当于曲面沿x轴方向的变化率,对y求偏导相当于曲面沿y轴方向的变化率。还有一些其它下面可能涉及到的求导公式:
然后再说一下求导的链式法则,即复合函数的导数等于内层函数导数乘外层函数导数。这个法则对于导数和偏导数都适用:
这个法则在平时计算导数时也是经常使用的,我们看个求导的简单例子:
但注意如果是多个子函数中都出现同一个求导的自变量a,那么链式法则就要变化一下了,需要每个涉及到自变量的都进行链式求导,再相加。
LoRA方法原理
LoRA简介
众所周知,大模型之所以有“大”这个字,是因为模型参数量非常大,训练和部署都需要较高的算力和内存(显存)。尤其是训练对于硬件的要求更高,在之前的文章中我们也描过:【AI】一文读懂大模型生态:分类/参数/结构/训练/GPU/评测/排行/社区。当我们想微调模型使其更好的适应某些任务或者知识时,如果将所有的参数一起调整,那么如此高的硬件要求会使得大部分开发者望而却步,无法实现。深度神经网络中的参数近似一个黑盒,我们无法区分出哪些参数对应哪些知识,精确的对某一部分参数做针对性调整。
那么有没有一种方法可以对大模型进行微调,但是不要求如此高的硬件性能,且不用精确挑选参数呢?有的,这就是LoRA方法。LoRA英文全称叫做Low-Rank Adaptation,即“低秩适应”方法,是由微软在2021年提出的,论文原文:[LoRA: Low-Rank Adaptation of Large Language Models(https://arxiv.org/abs/2106.09685)。
在大模型的每层中,有Q/K/V/O几个矩阵,这些矩阵的行数和列数都和向量维度有关,例如在Qwen3-0.6B中是1024×1024和1024×2048,每个矩阵的参数量都非常大。实际使用LoRA方法时,可以对这些矩阵全部微调,或者只选择部分微调。我们来看一下公式,这里以1024×1024为例说明。
如果对所有参数都进行调整,这叫做“全量微调”,相当于在W旁边挂一个和W一样参数量的矩阵,它对于硬件的要求非常高。
但LoRA方法,将些矩阵冻结不修改,而是在旁边挂A和B两个小矩阵,通过调整两个小矩阵的参数值来影响最终结果。
其中a和r为超参数。超参数的含义是我们在训练之前就提前确定好的参数,训练过程中不会变化。虽然训练中不会变化,但参数值对于模型表现还是有较大影响的,甚至有时需要尝试针对不同的超参数进行训练。
r表示AB两个矩阵的行数和列数,一般可以取8,16,64等值。这里我们以8来举例。对于一个矩阵,全量微调需要调整的参数量为1024×1024=1048576。而LoRA方法仅需调整AB两个矩阵,参数量为2×1024×8=16384。16384/1048576=0.015%,也就是说通过LoRA使用r=8的参数,调整的参数量为全量微调的0.015%。
同时矩阵乘法的性质,
a表示缩放比例。这个超参数如果固定不变,当r增大时,可以抵消由于矩阵维度增加带来数字增加,使得调节幅度突然增大的问题。但也有很多人与r搭配使用,使得a/r之后的数字相同,代表BA矩阵在不同的r下采用相同的缩放系数。
在实际应用中,BA矩阵可以合并进模型中,永久修改参数值,也可以保留外挂形式,甚至可以针对不同的任务微调不同的参数,使用时再切换不同的外挂矩阵。
简化计算
合并进原模型矩阵时需要计算BA相乘,组成1024×1024的矩阵。但在LoRA训练时,却不需要这么处理,而是走一条计算量更少的路,这里我们对比两种计算方式。其中每个操作计算方式为结果矩阵元素个数*单个元素的计算量。第一种是计算BA相乘的方式:
可以看到,第一种方式计算量最大的就是BA相乘。第二种是先另A与X相乘,这样会得到一个8维的向量,再用这个向量与B相乘,这种方式可以大幅缩减原有BA相乘的计算消耗:
通过计算结果可以看到,不管是乘法还是加法都明显大幅下降,这里我们再给出下降的比例,这里以乘法为例:
- 9437184/1064960 = 8.86 第一种的计算量是第二种的接近9倍
- 不使用LoRA方法的场景:只有WX这一个矩阵乘法计算,计算量为1048576
- 9437184/1048576 = 9 以第一种方式使用LoRA,计算量为不使用的9倍
- 1064960/1048576 = 1.0156 以第二种方式使用LoRA,计算量仅增加了1.56%
仅通过改变计算的先后顺序,能做到计算量相比不使用LoRA仅有微小的上涨,实际使用时可以几乎忽略不计。
低秩证明
前面说到LoRA的中文名叫做“低秩适应”,这里的秩表示的就是矩阵的秩,低秩意思是它用一个秩较低的矩阵取适应这个大的W矩阵,这里秩的值就是超参数r。
前面说过r值是矩阵A和B的列数和行数,那么A和B的矩阵的秩是小于等于r的。那么BA相乘的组合矩阵,虽然维度是1024×1024,但是秩依然是小于等于r的。事实上它不超过A的秩,也不超过B的秩。这里我们证明一下这个结论:
可以看到,通过将矩阵乘法后的每一行拆分,可以将b看作系数,结果矩阵中的每一行都是由不同的B的系数乘以A矩阵中的每一行组成的(公式中为了方便说明以列向量表示,实际都是A的行向量)。通过这种方式,结果矩阵的每一行都是A矩阵的组合,根据矩阵的秩的定义,那么结果矩阵的秩肯定小于等于矩阵A的秩。
同理,我们查看结果矩阵的每一列,发现可以表示A矩阵作为系数,B的列向量作为结果矩阵每一列的组成部分。这里公式未列出,可以自行推导。因此结果矩阵的秩肯定小于等于矩阵B的秩。这里就证明了前面的结论:BA相乘的结果矩阵的秩,不超过A的秩,也不超过B的秩。
我们一般把r叫做LoRA训练后矩阵的秩。理论上训练结果的秩最大是r,小于r也是可能的。在实际的模型训练中,由于r的取值一般比较小,实际上都能让AB矩阵的秩达到r的状态。
使用LoRA来修改模型参数,好处是模型参数量小使得存储空间占用小,且训练容易。但低秩特性也有一些劣势,与全量微调的效果是有差距的。例如可以用LoRA做到调整输出风格,适配简单任务,但在学习有些新知识方面却较难做到。
初始化和均匀分布
在训练之前,首先将AB两个矩阵初始化。其中A矩阵的每个元素初始化为随机数,B矩阵初始化为全0矩阵。这样在开始训练时得到的结果与原模型一致。
在这个初始化基础上,每次输入训练数据得到输出token,再根据输出token是否正确来反向更新AB矩阵的每个参数,每次只更新一个很小的值。最后训练完毕后得到AB矩阵最终的参数值。
那么应该如何A矩阵的初始化方式呢?理论上任意的随机数都可以,因为模型训练时会逐步调整参数值。但部分不合理的初始化方式会使得模型初始化时偏差较大,致使参数调整过程更长也更难。因此,合理的初始化方式可以让训练过程更轻松,更容易达到想要的结果。
微软在当年提出的论文中,使用的是高斯分布来生成随机数。但目前最常用的是采用Kaiming Uniform分布(均匀分布)来实现,这也是各大框架的默认方式。这是由中国人何恺明发明的,他还发明了深度残差网络(ResNet),现在几乎所有大模型都在使用。
首先介绍下均匀分布。均分分布指的是设定一个范围,在这个范围内生成随机数,且随机数的在这个范围内每个位置出现的可能性都是一样的。例如范围为(0,10),则随机数在(0,5)之间的概率和(5,10)一致,都是50%;且和(3,8)的概率也一致。
然后再介绍一下Kaiming Uniform分布,这个分布是为了ReLU激活函数设计的权重初始化方法。它的均匀分布中点为0,分布的范围是这样:(-bound, bound)。其中bound的计算公式如下:
其中a与RELU有关,fan_in指的是输入维度的的个数。但本文的LoRA与激活函数是两回事,因此这里就不介绍公式和ReLU了。在PyTorch中为了和之前的分布公式做兼容,LoRA中的a值默认取
这就是LoRA中A矩阵初始化随机数的分布范围计算公式。带入fan_in的值为1024,最后计算出bound的结果为1/32 = 0.03125。因此均匀分布的范围就是 (-0.03125,0.03125)。
Softmax归一化函数
前面我们介绍了LoRA方法的技术原理,也提到了如何对LoRA进行初始化,但是没有描述如何训练,怎么对这些参数进行更新。事实上,对LoRA中的AB矩阵进行训练的方式,与在原模型中训练方式的方式是一致的。都是先输入一段文本,转换成token列表,正向计算一遍输出预测下一个token的概率。然后与正确结果比较,通过反向传播更新参数值。只不过更新的参数值不一样。为了更好的理解参数训练流程,介绍一下从输出结果开始的部分参数训练的原理。首先介绍的是Softmax归一化函数。
通过大模型神经网络一层一层计算,最后得到的输出是一个向量,长度为词表长度,其中每个值为词表中每个token的对应值。这个值越大,表示预测为这个token的概率越高。但这个值可能是正数,也可能是负数,甚至可能向量中每个值都是负数。此时肯定不能将所有值简单相加算概率,否则就会出现负的概率值,而且可能某些token的概率超过1。这里举个几个例子:
这明显是不可行的。因此需要一个归一化函数,将这些值对应位每个token对应的概率值,同时保证不会出现负值,且所有概率值相加为1。Softmax就是一个指数归一化函数。这里列举函数的计算公式:
可以看到,公式其实比较简单,就是将前面我们直接将输出值相加,改成了先计算指数再加和计算概率。因为不管原值如何,经过指数运算之后都变成了正值,因此保证了所有概率值相加为1,且不会出现负值。Softmax仅仅是比较值之间的差,根据差值计算概率。对于值中的“相同部分”并不会影响概率值。这里举几个例子:
通过上面的例子可以看到,虽然第一个例子是1,2,3;第二个例子是101,102,103;但我们利用指数运算性质,拆分出例子2中每个值的相同部分,然后被分子分母约掉,就只剩下每个数之间相差的部分了。因此Softmax做到了仅根据值之间的差来计算概率。
注意这是训练时计算概率值的方式。推理时也使用Softmax计算概率,但输出会多一些处理。这里是描述训练过程,因此不介绍推理的相关步骤。
损失函数和交叉熵
损失函数概念
前面我们通过Softmax函数,拿到大模型预测每个Token的概率值。在训练时,我们使用的是带答案的训练集数据,因此会有一个正确的输出token值。但只拿到这些还不够,大模型需要一个值来表示模型距离预测正确还有多远,即把大模型输出值和训练集“正确值”比较,看看模型预测的是正确还是错误,错误的量是多少。这样可以对模型当前预测结果给一个定量的评价,再根据这个评价调整参数值。这就是损失函数需要做的事情。
有人会说,这太简单了。如果模型预测token和训练集的正确token一致,那说明模型预测正确,如果不一致,就是模型预测错误。但这样只解决了正确性问题,没有定量的结果。试想模型输出的token值是一个概率,这个概率的大小不同,对于模型的评价应该是不一样的:
例子1和例子2都预测正确了,但是概率值相差巨大,对于模型的评价应该是一样的么?例子1和例子2都预测正确了,但错误的概率值相差巨大,对于模型的评价应该是一样的么?希望回答这些问题,就要找一个合适的损失函数来评价大模型场景的输出。
大模型场景实际上是一种One-hot分类场景,即输出值是一个向量,向量中的每个数字是这个分类的概率,但是只有一个分类是正确的。适用于One-hot分类场景的损失函数就是交叉熵。如果是多分类场景,例如给图像打标签,但是允许一个图像有多个标签,这时候就不能用交叉熵,需要采用其他损失函数。
损失函数的英文名叫做loss function,其中的损失就是loss。损失函数的入参为模型的输出值和训练集给出的结果,出参为得到的损失值,即模型离“完全正确”有多远。因此损失函数的输出一般为非负数,0值表示完全正确,值越大说明损失越大,即离正确越远。
信息量
想要了解交叉熵,需要先了解信息量和熵的概念。信息量指的是一个事件发生时,提供给我们的信息有多少,或者说事件发生时我们的惊讶程度。例如一个概率为99%的事件发生时,信息量比较小,因为它几乎时必然发生的。但是当概率为1%的事件发生时,我们会非常惊讶,因为基本不可能发生的事情发生了。因此,信息量有如下的特点:
- 事件发生的概率越小,当这个事件真正发生时,信息量就越大。
- 概率为100%的事件发生时,信息量为0,概率为0的事件发生时,信息量为无穷大。
- 信息量为非负数。
- 如果两个事件独立,则两个事件同时发生时的信息量等于两个事件单独发生时的信息量相加。
因此,在满足这些条件的基础上,将信息量的公式定义如下:
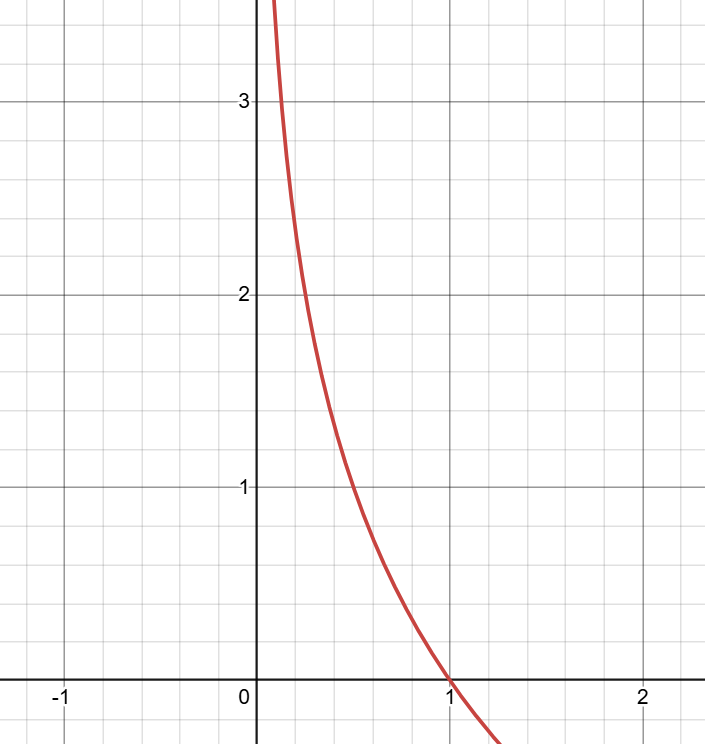
通过对应的公式曲线图,可以看到当处于横坐标(也就是概率值)处于0-1的范围内时,函数值从无穷开始逐渐下降,一直到0。这里再明确计算下上面说的性质:
前面的公式中我们只用了log,没有提到底数值,事实上不同场景使用的底数不同。当希望计算信息量对应的二进制位时,以2为底数计算;而在深度学习大模型中,为了计算方便使用e为底数。这里举例下以2为底时,直接求得的信息量值,就是需要的二进制位表示。
这里的二进制位是什么意思呢,可以看作是这个概率所需要的平均编码位数的最低值。这里举几个例子:
- 四个事件,每个概率1/4。每个信息量为2。分别编码为 00 01 10 11 编码长度一致
- 四个事件,每个概率为1/2, 1/4, 1/8, 1/8。对应信息量为1,2,3,3。对应哈夫曼编码为:0 10 110 111。编码长度一致。
- 三个事件,每个概率1/3。每个信息量约为1.58。对应哈夫曼编码为:0 10 11。 平均编码长度5/3 ≈ 1.67 > 信息量。
可以看到,当概率是2的n次方时,使用哈夫曼编码的长度与信息量一致。但如果信息量计算结果非整数,那么哈夫曼编码的每个元素必须是整数值,因此可能达不到最小值。
信息熵
前面描述的信息量,表示的是单个事件发生时的信息多少或者惊讶程度。那么对于一个完整的分布(即多个互斥事件的组合,加起来概率为1)它的平均信息量则用信息熵来表示,它是信息量的期望,也就是整个分布的平均惊讶程度。计算公式如下:
可以看到,实际上就是每个事件发生的信息量乘事件发生的概率。以通常意义来讲,如果这个分布确定性较高,那么信息熵比较小,如果分布的更随机,那么信息熵就更大。当事件个数固定,每个事件的概率相等时,分布最随机,此时信息熵最大。这里举个以2为底的例子:
- 两个事件,每个概率1/2。信息熵为1.
- 两个事件,概率分别为1/4,3/4。信息熵为1/2 + 3/4*0.415 ≈ 0.81
- 三个事件,每个概率1/3。信息熵约为1.58。
- 三个事件,概率分别为1/8,1/8,3/4。信息熵为3/8 + 3/8 + 3/4*0.415 ≈ 1.06
- 三个事件,概率分为1,0,0 信息熵为0
这个现象背后的含义是,如果每个事件概率相等,则最终哪个事件发生是非常不确定的,难以预测的。但如果某个事件概率较高(对应其它事件概率较低),那么说明这个分布更容易发生这个事件,更容易预测,则信息熵更低。极端情况下,当某个事件概率为1,必然发生,则这个分布整体是没有不确定性的,此时信息熵为0。
交叉熵
前面描述的信息熵,表达了真实世界(或者说正确的)事件发生的概率分布所代表的平均信息量。对于模型来说,它不知道正确的概率分布是什么,它有一个自己的概率分布,通过学习来预测和逼近正确的概率分布,这就是大模型学习的意义。大模型预测的概率分布和正确的概率分布是有差别的,那么如果来描述这个差别呢,就要交叉熵。
可以看到公式和信息熵非常相似,区别在于是以真实发生的概率乘模型预测概率的信息量,可以理解为真实事件发生时,我们心里想的是预测分布,以预测分布的角度对事件的平均惊讶程度。当我们预测的概率分布与真实分布完全一致时,交叉熵的格式就与信息熵完全一致了。
交叉熵减去信息熵的差值有个名称,叫做KL散度(Kullback-Leibler Divergence),用于表示两个分布之间的差异。KL散度的公式如下:
为什么叫做“散度”?这个词的直观可以理解为“散开的程度”。其实它也想叫做“距离”,但是因为不完全满足距离的几个条件,因此被叫做散度。(下面的条件可以随便举个例子来证明不满足,这里证明就不列出了)
- 对称性 不满足 H(p,q) ≠ H(q,p)
- 非负性 满足
- 相同对象距离为0 满足
- 三角不等式,即三个对象两两连接,任意两条边距离的和大于第三条边的距离 不满足
交叉熵永远大于等于信息熵,且相等时表示预测分布与真实分布一致。也就是说KL散度的永远大于等于0,这也就是吉布斯不等式的定义。这里给出证明:
注意看,虽然前面对数的不等式只对自然对数成立,但我们利用换底公式把任意底数转换为了自然对数,同时提出一个公共常数。由于最后减号两侧互相抵消,因此常数部分被不起作用。
在深度学习中,经常使用交叉熵作为概率分类的损失函数使用,交叉熵的值越小,即KL散度越小,则模型越逼近正确的概率分布,即模型的效果越好(当然也可能是过拟合了)。但是在大模型这种One-hot分类场景中,正确分布只有一个值,概率为1,因此交叉熵会在上述公式的基础上简化为非常简单的形式:
反向传播和梯度
概念说明
大模型接收token列表,通过多层深度神经网络处理,最后输出一个词表长度的向量,这个向量的名字叫做logits。然后再使用前面介绍的Softmax归一化为概率向量,再通过交叉熵损失函数最后求得loss值。这个完整的过程叫做前向传播,除了计算loss之外,和推理过程是基本一致的。loss值可以评价模型离“正确输出”有多远,使用loss值作为基础,从后到前反向通过每一层神经网络,指导每个参数应该如何更新,即修改参数值。这就是反向传播的过程。
要知道大模型参数值非常巨大,如何根据loss值计算出每个参数应该更新多少呢?这就要通过梯度的方式。梯度实际上是每个参数对于loss的偏导数,即每个参数对于loss值的变化率。
试想我们计算loss的目的是通过loss来修改参数值,最终使得loss值变小。训练时需要经过大量数据,每个数据都会产生一个loss值,都会去更新每个参数值;那么每个数据对于参数值的影响,即每次修改的参数值范围是很小的。这里就和偏导数的直观含义类似:即参数有一个微小变化时,会对loss值产生一个微小的影响,这个微小影响就是参数在这个值的变化率,即偏导数。
因此,梯度就是偏导数。反向传播的概念就是通过loss值,一步一步从后向前计算出每个参数的偏导数。最后再将梯度输入优化器,通过优化器给参数一个微小改动,从而使得模型拥有学习和调整能力。注意优化器和修改参数值本身并不属于反向传播的过程。
我们可以把神经网络看作是一个超大的函数。前向传播时,函数的变量是token向量,网络中的参数值是常量。但反向传播时,我们把神经网络入参看作是不变的常量,将网络中的参数值看作是变量,通过这种方式来求偏导数。
logits梯度
前面介绍过,神经网络的输出在经过Softmax归一化之前的向量,叫做logits。梯度的计算的起点就是logits,这里首先要计算logits中的每一个值对于的loss的偏导数。将交叉熵损失函数和Softmax合并起来一起计算偏导,会更简单,因此先尝试合并计算的方式。首先是列出两个函数合并后的公式表示:
可以看到,这个公式和正确token对应的词表序号有关,因此求偏导时要分为两种场景,这里分别给出证明:
可以看到,经过合并和化简,使用很简单的方式就可以求出偏导数,结果也非常简洁。这就是logits向量中每个元素对于损失的梯度。
分开证明
前面介绍了合并计算的方式,但实际上单独对于交叉熵和Softmax求偏导计算梯度,也是可行的,就是麻烦一点(事实上也不是很麻烦,一开始我打算试一下看能求么,没想到直接就做出来了)。这里我们尝试将两个函数分开求偏导。首先求归一化后的向量对于loss的偏导数是非常简单的:
根据链式求导法则,如果想算loss对于logits的偏导数,可以分别求loss对于归一化向量的偏导数,乘以归一化向量对于logits的偏导数。第一个我们前面已经算出来了,第二个就是Softmax函数。
再根据链式法则合起来计算Loss对于logits的偏导数。注意首先纠正一个错误的求法:
L即loss时一个数字,但是Q即概率是一个向量,这个向量里面的每个值都是一个关于A向量中所有值的函数,因此L对ai中实际上包含了Q的所有参数。因此需要这样计算:
由于我们前面只求了Q和A中下标相等的场景,这里再求一下不相等时候的偏导数。
那么现在分开的偏导数已经全部求出来了,现在将他们拼合起来,求L对于A的偏导数:
废了一番功夫,这样我们就得到了和前面合并计算一样的梯度计算结果。虽然计算过程并不难,但确实比合并计算要麻烦,在模型实际运算中,因为合并计算公式简洁简单,因此都不选择分开计算。
梯度传播
我们求得logits向量的梯度,实际上只是反向传播的第一步。logits是大模型的“中间结果”,并不是我们直接要调整的参数,因此我们还要继续从后向前传播,算出前面每个参数的梯度值。这里我们以一个线性层来举例梯度在神经网络中是如何计算的。对于非线性层,也是类似的计算方式。
设词表长度为m;大模型向量维度为n,则一个线性层的矩阵计算公式可以这样举例。其中Y是输出向量,X是输入向量,A和B分别是模型中的参数。
在前向传播中,我们以X作为自变量计算结果。但是在反向传播计算梯度时,计算哪个参数的梯度,哪个参数就要作为自变量,其余的参数则作为常量。为了方便理解,这里我们可以假设Y就是logits向量。假设要求loss对AB等参数的梯度,按照链式求导法则,我们已经求得了L对Y的偏导数,因此只需要求Y对A和B的偏导数即可。
在实际模型计算时,并不需要得到loss对AB等参数的真正梯度公式,只需要计算出值来就好了。因此在上一步logits向量的梯度计算后,我们拿到的是logits向量的梯度实际值,不需要再合并公式了。且模型层数越长,这个公式恐怕非常难表示。
雅可比矩阵 对ABX分别求梯度。 然后再向前。
优化器
SGD AdamW
总结
还有很多在LoRA基础上改进的方法
参考
- 【AI】一文读懂大模型生态:分类/参数/结构/训练/GPU/评测/排行/社区
https://jzplp.github.io/2026/llm-stru.html - 【AI】大模型本地部署与量化:Ollama、transformers、llama.cpp实践
https://jzplp.github.io/2026/llm-deploy.html - LaTeXLive在线公式编辑器
https://www.latexlive.com/ - 图解大模型微调系列之:大模型低秩适配器LoRA(原理篇)
https://zhuanlan.zhihu.com/p/646831196 - LoRA这种微调方法和全参数比起来有什么劣势吗?
https://www.zhihu.com/question/608674675 - 数学图形工具组
https://www.desmos.com/?lang=zh-CN - 图解 Fine-tuning:LoRA 系列微调技术概述
https://zhuanlan.zhihu.com/p/990958034 - LoRA: Low-Rank Adaptation of Large Language Models
https://arxiv.org/abs/2106.09685 - LoRA论文对应代码
https://github.com/microsoft/LoRA - 什么是信息量、信息熵、交叉熵与KL散度,及其相互之间的关系
https://www.bilibili.com/video/BV1mkgwzZEN9 - 别死记公式!8分钟带你通透损失函数本质!
https://www.bilibili.com/video/BV1GHS1BzE6J