【AI】大模型LoRA微调的原理和实验(未完成)
数学基础和训练原理补充
矩阵的秩
首先介绍一下矩阵的初等变换。矩阵的初等变换有行变换和列变换,规则是一致的,这里以行变换说明。以下几种变换是初等行变换:
- 交换任意两行的位置
- 非0的常数乘任意一行
- 把任意一行乘以非0常数,加到另一行上面
如果一个矩阵经过任意数量的初等变换之后,尽量将矩阵中的行(或者列)变为全0。剩下的无法变化的行数(或列数)就是矩阵的秩。如何可以变为全0?如果一行是其它行的倍数,或者可以被其它多个行经过倍数和加减表示,那么这一行就可以变为0。
例如下面的例子,第二行是第一行的两倍,那么第二行=第一行*2,第四行=第一行+第三行,那么第二行和第四行都可以经过初等行变换处理为全0行。
剩下无法被其它向量表示的向量,都是线性无关的,这些线性无关的向量个数即是矩阵的秩。从信息论的角度来说,这些可以被其它向量表示的向量,是不增加信息量的,它自身没有存在价值,属于冗余参数。
梯度裁剪
在【AI】大模型参数训练原理:Softmax/损失函数交叉熵/反向传播/梯度下降优化器/学习率调度器/训练数据划分中我们介绍了部分参数训练原理,但还有部分训练时默认启用的参数更新逻辑没有介绍到,这里我们补充介绍一下。
梯度裁剪的英文叫做Gradient Clipping,作用位置在反向传播,计算出所有参数的梯度值之后,在梯度下降优化器更新参数值之前。作用为当参数梯度过大时,对其进行缩小。一般使用全局范数裁剪的方法,即计算出全部参数梯度的L2范数,当大于一个固定超参数值c时,对所有参数进行同比例的缩小。
公式实际上非常简单,计算出所有参数的L2范数之后,和裁剪阈值比较,如果小于阈值和不改变梯度。如果大于阈值,则把所有参数的梯度值都乘以一个小于1的系数,注意是所有参数都处理,即使这个参数的梯度值本身非常小了,也要被继续缩小。计算出来的新梯度值串入梯度下降优化器中更新参数处理。
处理什么问题? 有什么作用? adamW本身不能处理么?
LoRA方法原理
LoRA简介
众所周知,大模型之所以有“大”这个字,是因为模型参数量非常大,训练和部署都需要较高的算力和内存(显存)。尤其是训练对于硬件的要求更高,在之前的文章中我们也描过:【AI】一文读懂大模型生态:分类/参数/结构/训练/GPU/评测/排行/社区。当我们想微调模型使其更好的适应某些任务或者知识时,如果将所有的参数一起调整,那么如此高的硬件要求会使得大部分开发者望而却步,无法实现。深度神经网络中的参数近似一个黑盒,我们无法区分出哪些参数对应哪些知识,精确的对某一部分参数做针对性调整。
那么有没有一种方法可以对大模型进行微调,但是不要求如此高的硬件性能,且不用精确挑选参数呢?有的,这就是LoRA方法。LoRA英文全称叫做Low-Rank Adaptation,即“低秩适应”方法,是由微软在2021年提出的,论文原文:LoRA: Low-Rank Adaptation of Large Language Models。
在大模型的每层中,有Q/K/V/O几个矩阵,这些矩阵的行数和列数都和向量维度有关,例如在Qwen3-0.6B中是1024×1024和1024×2048,每个矩阵的参数量都非常大。实际使用LoRA方法时,可以对这些矩阵全部微调,或者只选择部分微调。我们来看一下公式,这里以1024×1024为例说明。
如果对所有参数都进行调整,这叫做“全量微调”,相当于在W旁边挂一个和W一样参数量的矩阵,它对于硬件的要求非常高。
但LoRA方法,将些矩阵冻结不修改,而是在旁边挂A和B两个小矩阵,通过调整两个小矩阵的参数值来影响最终结果。
其中a和r为超参数。超参数的含义是我们在训练之前就提前确定好的参数,训练过程中不会变化。虽然训练中不会变化,但参数值对于模型表现还是有较大影响的,甚至有时需要尝试针对不同的超参数进行训练。
r表示AB两个矩阵的行数和列数,一般可以取8,16,64等值。这里我们以8来举例。对于一个矩阵,全量微调需要调整的参数量为1024×1024=1048576。而LoRA方法仅需调整AB两个矩阵,参数量为2×1024×8=16384。16384/1048576=1.56%,也就是说通过LoRA使用r=8的参数,调整的参数量为全量微调的1.56%。
同时矩阵乘法的性质,
a表示缩放比例。这个超参数如果固定不变,当r增大时,可以抵消由于矩阵维度增加带来数字增加,使得调节幅度突然增大的问题。但也有很多人与r搭配使用,使得a/r之后的数字相同,代表BA矩阵在不同的r下采用相同的缩放系数。
在实际应用中,BA矩阵可以合并进模型中,永久修改参数值,也可以保留外挂形式,甚至可以针对不同的任务微调不同的参数,使用时再切换不同的外挂矩阵。
简化计算
合并进原模型矩阵时需要计算BA相乘,组成1024×1024的矩阵。但在LoRA训练时,却不需要这么处理,而是走一条计算量更少的路,这里我们对比两种计算方式。其中每个操作计算方式为结果矩阵元素个数*单个元素的计算量。第一种是计算BA相乘的方式:
可以看到,第一种方式计算量最大的就是BA相乘。第二种是先另A与X相乘,这样会得到一个8维的向量,再用这个向量与B相乘,这种方式可以大幅缩减原有BA相乘的计算消耗:
通过计算结果可以看到,不管是乘法还是加法都明显大幅下降,这里我们再给出下降的比例,这里以乘法为例:
- 9437184/1064960 = 8.86 第一种的计算量是第二种的接近9倍
- 不使用LoRA方法的场景:只有WX这一个矩阵乘法计算,计算量为1048576
- 9437184/1048576 = 9 以第一种方式使用LoRA,计算量为不使用的9倍
- 1064960/1048576 = 1.0156 以第二种方式使用LoRA,计算量仅增加了1.56%
仅通过改变计算的先后顺序,能做到计算量相比不使用LoRA仅有微小的上涨,实际使用时可以几乎忽略不计。
低秩证明
前面说到LoRA的中文名叫做“低秩适应”,这里的秩表示的就是矩阵的秩,低秩意思是它用一个秩较低的矩阵取适应这个大的W矩阵,这里秩的值就是超参数r。
前面说过r值是矩阵A和B的列数和行数,那么A和B的矩阵的秩是小于等于r的。那么BA相乘的组合矩阵,虽然维度是1024×1024,但是秩依然是小于等于r的。事实上它不超过A的秩,也不超过B的秩。这里我们证明一下这个结论:
可以看到,通过将矩阵乘法后的每一行拆分,可以将b看作系数,结果矩阵中的每一行都是由不同的B的系数乘以A矩阵中的每一行组成的(公式中为了方便说明以列向量表示,实际都是A的行向量)。通过这种方式,结果矩阵的每一行都是A矩阵的组合,根据矩阵的秩的定义,那么结果矩阵的秩肯定小于等于矩阵A的秩。
同理,我们查看结果矩阵的每一列,发现可以表示A矩阵作为系数,B的列向量作为结果矩阵每一列的组成部分。这里公式未列出,可以自行推导。因此结果矩阵的秩肯定小于等于矩阵B的秩。这里就证明了前面的结论:BA相乘的结果矩阵的秩,不超过A的秩,也不超过B的秩。
我们一般把r叫做LoRA训练后矩阵的秩。理论上训练结果的秩最大是r,小于r也是可能的。在实际的模型训练中,由于r的取值一般比较小,一般都能让AB矩阵的秩达到r的状态。
使用LoRA来修改模型参数,好处是模型参数量小使得存储空间占用小,且训练容易。但低秩特性也有一些劣势,与全量微调的效果是有差距的。例如可以用LoRA做到调整输出风格,适配简单任务,但在学习有些新知识方面却较难做到。
初始化和均匀分布
在训练之前,首先将AB两个矩阵初始化。其中A矩阵的每个元素初始化为随机数,B矩阵初始化为全0矩阵。这样在开始训练时得到的结果与原模型一致。
在这个初始化基础上,每次输入训练数据得到输出token,再根据输出token是否正确来反向更新AB矩阵的每个参数,每次只更新一个很小的值。最后训练完毕后得到AB矩阵最终的参数值。
那么应该如何A矩阵的初始化方式呢?理论上任意的随机数都可以,因为模型训练时会逐步调整参数值。但部分不合理的初始化方式会使得模型初始化时偏差较大,致使参数调整过程更长也更难。因此,合理的初始化方式可以让训练过程更轻松,更容易达到想要的结果。
微软在当年提出的论文中,使用的是高斯分布来生成随机数。但目前最常用的是采用Kaiming Uniform分布(均匀分布)来实现,这也是各大框架的默认方式。这是由中国人何恺明发明的,他还发明了深度残差网络(ResNet),现在几乎所有大模型都在使用。
首先介绍下均匀分布。均分分布指的是设定一个范围,在这个范围内生成随机数,且随机数的在这个范围内每个位置出现的可能性都是一样的。例如范围为(0,10),则随机数在(0,5)之间的概率和(5,10)一致,都是50%;且和(3,8)的概率也一致。
然后再介绍一下Kaiming Uniform分布,这个分布是为了ReLU激活函数设计的权重初始化方法。它的均匀分布中点为0,分布的范围是这样:(-bound, bound)。其中bound的计算公式如下:
其中a与RELU有关,fan_in指的是输入维度的的个数。但本文的LoRA与激活函数是两回事,因此这里就不介绍公式和ReLU了。在PyTorch中为了和之前的分布公式做兼容,LoRA中的a值默认取
这就是LoRA中A矩阵初始化随机数的分布范围计算公式。带入fan_in的值为1024,最后计算出bound的结果为1/32 = 0.03125。因此均匀分布的范围就是 (-0.03125,0.03125)。
CMRC2018数据集
数据集介绍
CMRC2018是哈工大讯飞联合实验室(HFL)再2018年发布的基于篇章片段抽取的阅读理解(Span-Extraction Machine Reading Comprehension)数据集,在CMRC2018发布之前,有一些英文阅读理解类数据集,但中文的没有。CMRC2018是首个人工标注的中文篇章片段抽取型阅读理解数据集。其中一条训练数据格式如下,由于文案太长,其中省略了部分:
[
  {
    "paragraphs": [
      {
        "id": "TRAIN_614",
        "context": "江苏路街道是中国上海市长宁区下辖的一个街道办事处,位于长宁区最东部,东到镇宁路接邻静安区的静安寺街道,【...省略】 户籍人口5.26万人,下辖13个居委会。较著名的近代建筑有中西女中(今上海市第三女子中学)、王伯群及汪精卫公馆(今长宁区少年宫)、西园公寓等。江苏路、长宁路、延安西路(高架)等经过拓宽,已经形成上海市的交通干道。【...省略】",
        "qas": [
          {
            "question": "江苏路街道在上海市的什么地方?",
            "id": "TRAIN_614_QUERY_0",
            "answers": [ { "text": "长宁区", "answer_start": 11 } ]
          },
          {
            "question": "江苏路街道下辖多少个居委会?",
            "id": "TRAIN_614_QUERY_1",
            "answers": [ { "text": "下辖13个居委会。", "answer_start": 126 } ]
          },
          {
            "question": "江苏路街道较著名的近代建筑有什么?",
            "id": "TRAIN_614_QUERY_2",
            "answers": [{ "text": "较著名的近代建筑有中西女中(今上海市第三女子中学)、王伯群及汪精卫公馆(今长宁区少年宫)、西园公寓等。",  "answer_start": 237 }]
          }
        ]
      }
    ],
    "id": "TRAIN_614",
    "title": "江苏路街道 (上海市)"
  }
]
其中context是一段约几百个字的文档,是从中文维基百科中节选的片段,其中包含了一些知识。文档后面是几个问题,每个问题都可以从文档中找到答案,而且答案肯定是原文中的一个连续的片段,即答案可以用文档字符串的下标表示,一个答案起始下标,一个结束下标。由于不需要人类或者模型来“生成式”的创作答案,因此这种类型的任务叫做“基于篇章片段抽取的阅读理解”。
数据集被分成了几个部分,每个部分有不同的数据数量和目的:
| 英文名称 | 中文名称 | 文档数量 | 问题数量 | 是否公开 | 作用 |
|---|---|---|---|---|---|
| train | 训练集 | 2403 | 10142 | 是 | 训练模型 |
| dev | 开发集 | 848 | 3219 | 是 | 测试模型性能 |
| trial | 试用集 | 256 | 1002 | 是 | 试用版数据,验证模型可以正常运行 |
| test | 测试集 | - | 4875 | 否 | 主办方非公开测试集,用来验证模型能力 |
| challenge | 挑战集 | - | 504 | 否 | 更难的主办方非公开测试集 |
其中训练集,开发集,试用集是我们可以直接下载到的,测试集和挑战集都是不公开的。同时主办方有一个排行榜,就是使用这两个数据集进行测试和统计排名,因此为了避免刷分不公开。开发集等数据中都提供了三份答案,这是由三个人工专家独立标注的答案数据,互相之间并未看过答案,因此可能相同也可能不同。我们在测试时,可以认为三个答案的任何一种都是正确的。开发集数据举例如下:
[
  {
    "paragraphs": [
      {
        "id": "DEV_148",
        "context": "西湾河电车厂(简称西电;,缩写:SWHD)是香港电车位于西湾河的电车厂。【...省略】",
        "qas": [
          {
            "question": "西湾河电车厂简称什么?",
            "id": "DEV_148_QUERY_0",
            "answers": [
              { "text": "西电", "answer_start": 9 },
              { "text": "西电", "answer_start": 9 },
              { "text": "西电", "answer_start": 9 }
            ]
          },
          {
            "question": "香港天文台发出什么信号时电车厂会暂停服务?",
            "id": "DEV_148_QUERY_1",
            "answers": [
              { "text": "一号戒备信号或三号强风信号", "answer_start": 187 },
              { "text": "一号戒备信号或三号强风信号", "answer_start": 187 },
              { "text": "预九号烈风或暴风增强信号或更高信号", "answer_start": 230 }
            ]
          }
        ]
      }
    ],
    "id": "DEV_148",
    "title": "西湾河电车厂"
  }
]
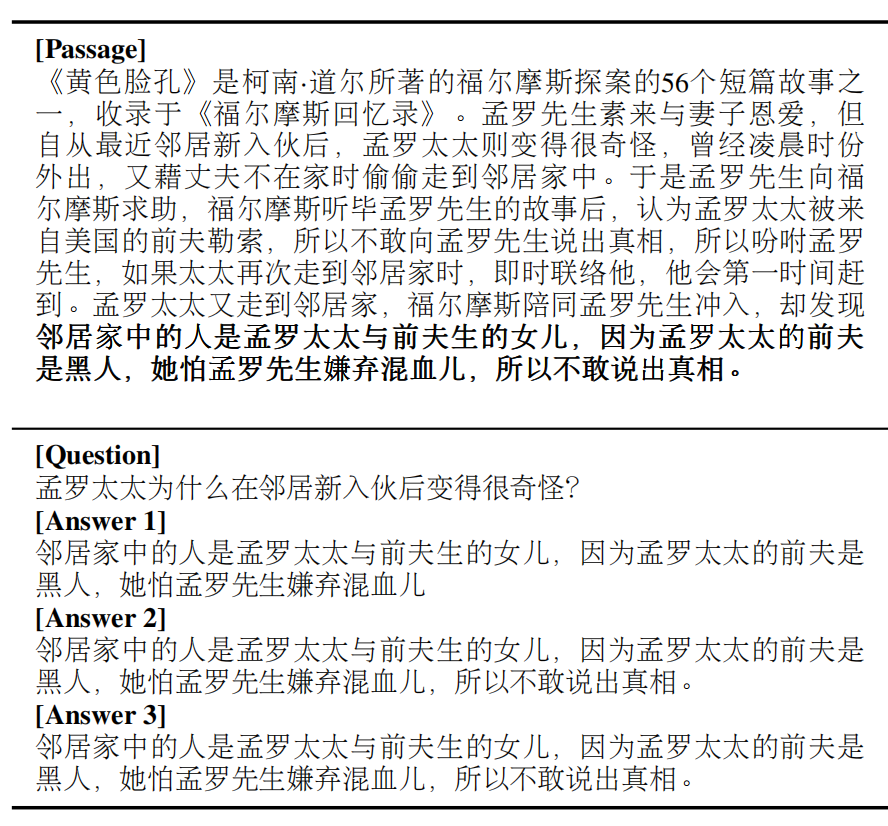
非公开测试集有测试集和挑战集两种,两种的数据的答案形式是一样的,都是可以用原文档字符串的下标表示。但是挑战集中的数据是精心设计过的,难度更高。一般的问题可能会在一个句子中就能找到答案,但挑战集却需要多个句子综合推理才能得到结果。如果答案属于命名实体或特定类别,则不能是上下文中唯一的一个,否则模型可以轻易按类型将其挑选出来。例如文档的答案是人名,则应该至少有两个人名出现在文档中。下图展示了数据集论文中的一个挑战集示例。
是否适用
从前面的数据集介绍可以得知,CMRC2018是一个文档片段抽取任务的数据集,它的答案只需要在原文中寻找,并不需要自己生成答案。但是大模型本身的机制是生成一段回答,并不是在原文中定位答案,因此看起来这个任务与大模型并不匹配。
但实际上,从已有文档中寻找答案是大模型的重要应用。例如法律,科研论文,客服等相关场景中,都是提前给大模型一些文案材料,当我们对模型提问时,模型必须准确的根据材料回答问题,不能自己编造答案,甚至需要找到答案在原文中的位置。
大模型有一种相关技术叫做RAG(Retrieval-Augmented Generation),中文名是检索增强生成。在模型之外,预先设置一个知识库(向量数据库),里面预先存放了很多处理好的文档切片。当用户提问时,首先把用户问题进行处理,处理后在知识库中检索相关文档。最后将用户问题和文档片段一起提供给大模型,最后由大模型输出答案。
我们发现,RAG最后提交给大模型的部分是一个文档片段+用户问题,这就与CMRC2018的任务非常类似了。通过对片段抽取数据集进行训练,可以提高模型在文档中搜索信息回答问题的能力。
这时候有同学想问,CMRC2018的任务必须输出文档原文,这对于大模型来说限制太大了。实际上这个限制有优势,也有劣势。我们知道大模型会出现幻觉,会输出错误的答案,甚至会创造一些不存在的东西。使用这种数据集来训练,将答案限制在原文内,可以让模型减少幻觉,尽量回答确定的知识。但是反之,模型本身的创造力和不确定性会减少,甚至可能变成“只会从原文中抄答案”的样式。如果数据集中可以存在一些反例,即文档中不存在答案的问题,同时答案为“不知道”,这样让模型学会不乱说话。但是CMRC2018数据集中并没有此类数据。
LoRA本身由于参数量级少,数据量也少,并不适合学习新知识,但适合学习输出风格,表达习惯,输出形式等。CMRC2018这个任务并不需要模型了解新知识(在文档中已经有了),仅仅是调整了输出模式,因此这个任务比较适合用LoRA来训练。
严格来说,如果要正式训练大模型,那么CMRC2018这个数据集肯定是有很多问题的,肯定不能直接作为训练数据使用。但这个任务本身有很重要的应用场景,且比较适合用LoRA来训练。同时我们使用的模型是qwen3-0.6B,模型参数量很小,不能做什么太复杂的任务。我们的目标也并不是训练出一个通用大模型,而是实验验证LoRA的有效性,看到模型在某个任务上是有进步的。因此我们选择本数据集进行实验。
当然这里我们说的都是实验开始前的估计,真正是否有效,还要真正做实验,调参,观察结果。
评价指标EM和F1
看主办方提供的排行榜,可以发现有两个指标:EM和F1。EM表示答案完全匹配,F1则是最大公共子串。在数据集仓库中还包含了cmrc2018_evaluate.py这个Python2的脚本文件,里面包含了这两种指标的具体计算方式,因此我们把数据集文件和大模型的预测结果输入进脚本中,就能计算这两个指标结果。下面我们详细介绍一下两个指标的处理过程。
EM(Exact Match),含义是完全匹配。首先将读取预测文本和数据集标准答案,对这些字符串去掉30个提前预设好的标点,即这些标点符号不作为结果评价的一部分。然后预测文本和三个标准答案进行比较,如果两个字符串“完全相同”说明回答正确,三个都没匹配上就是回答错误。最后计算正确个数/问题总个数,乘以百分比输出结果。
F1的计算则比较麻烦。首先还是将预测文本和数据集标准答案去掉30个提前预设好的标点。然后对这些字符串分割为token列表,注意这里的token分割方法和大模型不一样:每隔中文字符是一个独立的token;连续的字母和标点符号被交给nltk这个分词工具进行分割,其内部逻辑大致为连续的字母分割成一个token,标点符号被分割成一个token。
现在预测文本和标准答案都变成了token列表,我们求这两个序列的最长连续子序列,即求两个序列中最长的重复部分的长度。注意必须是连续的。例子如下:
标准答案(长度7):你 好 世 界 我 是 AI
预测文本(长度6):世 界 我 是 你 AI
公共子串(长度4):世 界 我 是
注意,AI这个token虽然在答案中,也在预测文本中,而且都是在最后位置;但它与最长公共子串并不连续,因此不能被计算。拿到公共子串后,就可以计算各种指标了,这些指标是通用指标,并不是这个任务独有的。
- 精确率:表示预测结果中有多少是正确的。预测无关内容越少,精确率越高。
- 召回率:表示预测正确部分占标准答案的比例。预测正确内容越全,召回率越高。
- F1:精确率和召回率的调和平均,衡量本次预测的综合指数。
这里介绍一下调和平均,这是一种平均数概念,适合用在比例和速度等场景上。调和的意思是倒数,例如调和级数就是1 + 1/2 + 1/3 + 1/4 ...。调和级数则是先对数字取倒数,再求平均,再取倒数。计算公式如下:
可以看到,经过公式转换后,公式和F1的形式一样了,即F1就是精确率和召回率的调和平均。关于调和平均数的特点,这里我们举个例子说明:
问题:两地距离为10,骑自行车来回。来的时候速度为10,回的时候速度为5,求平均速度。
普通平均数: (10 + 5) / 2 = 7.5
调和平均数: 2*10*5 / (10 + 5) ~= 6.66
正确答案:来回总距离20。总时间为3。平均速度为 20/3 ~= 6.66
可以看到,像速度这类数字,并不能直接求平均数,使用调和平均则可以达到正确的答案。注意这里需要两地距离相同,如果距离不同则需要乘以对应权重了,由于和本问题无关,这里就不介绍了。回到F1上来,使用调和平均数,如果某个指标较差,可以明显的反映出来。例如:
标准答案(长度10):你 好 世 界 我 是 语 言 模 型
预测文本(长度1):我
公共子串(长度1):我
精确率 = 1
召回率 = 1/10
普通平均数:(1 + 1/10) / 2 = 0.55
F1 = 2 * 1 * 1/10 / (1 + 1/10) = 2/11 ~= 0.18
可以看到,在上面的例子中,虽然只预测了一个字符,但精确率高达100%。如果使用普通平均数,我们或许会认为预测的还不错,但它并不能真实反映实际结果好坏。F1的比例值才比较合理,它会更多收到较小值的影响,拉低整体结果。从这个例子中也能看到,精确率和召回率都是由局限性的,可能整体看效果并不好,但是某个指标却可能比较高。
最后把所有问题的F1值相加,除以问题总个数,就得到了平均F1值,乘以百分比输出结果。
模型测试
在训练之前,我们先用数据集跑一遍模型,看看在不训练的场景下,模型能拿到什么样的分数,作为参考。同时也与训练后提升的分数做对比。同时测试代码也能用作训练中跑验证集,训练后跑测试集使用。
测试代码
这里使用PyTorch和transformers调用大模型,后面也用这两个库训练。
import json
import time
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

# trial 数据集
INPUT_FILE = "squad-style-data/cmrc2018_trial.json"
# 预测结果输出文件
OUTPUT_FILE = "squad-style-data/cmrc2018_trial_result.json"
# 模型文件路径
MODEL_NAME = "../Qwen3-0.6B"
# 记录起点,用于统计总耗时
START_TIME = time.perf_counter()

# 读取squad格式数据集,输出数组中元素为{id, question, context}
def load_samples(path):
    dataset = json.load(open(path, encoding="utf-8"))
    samples = []
    for article in dataset["data"]:
        for para in article["paragraphs"]:
            for qa in para["qas"]:
                samples.append(
                    {
                        "id": qa["id"],
                        "question": qa["question"],
                        "context": para["context"],
                    }
                )
    return samples

# 构造单轮对话消息,要求模型只输出材料中的原文答案
def build_prompt(question, context):
    return [
        {
            "role": "user",
            "content": (
                "请阅读下面的材料,回答问题。"
                "答案必须来自材料原文,直接输出答案文本,不要输出其他任何内容。\n\n"
                f"材料:{context}\n\n问题:{question}\n答案:"
            ),
        }
    ]

# 对单条问题做一次生成答案字符串并返回
def generate_answer(model, tokenizer, messages):
    # 套用 Qwen3 的对话模板 enable_thinking=False 关闭思考模式
    text = tokenizer.apply_chat_template(
      messages, tokenize=False, add_generation_prompt=True, enable_thinking=False
    )
    inputs = tokenizer(text, return_tensors="pt").to(model.device)
    # no_grad:推理阶段关闭梯度记录
    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=512, # 最多生成512个token
            do_sample=False, # 贪心解码
        )
    # 只解码新生成的部分(去掉输入的 prompt)
    response = tokenizer.decode(
        outputs[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True
    )
    # 取第一行非空文本作为答案
    return response or ""

# ---- 主流程 ----
# 加载问题数据
samples = load_samples(INPUT_FILE)
# 加载分词器
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
# 加载模型
model = AutoModelForCausalLM.from_pretrained(
    MODEL_NAME, torch_dtype="auto"
)
# 推理模式,关闭 dropout
model.eval()

# 逐条提问,收集 {问题id: 答案}
results = {}
# enumerate 在遍历时同时给出下标和元素
for i, sample in enumerate(samples):
    # 本条问题的计时起点
    q_start = time.perf_counter()
    # 生成答案
    answer = generate_answer(model, tokenizer, build_prompt(sample["question"], sample["context"]))
    results[sample["id"]] = answer
    # 本条问题耗时
    q_time = time.perf_counter() - q_start
    print(f"[{i + 1}/{len(samples)}] {sample['id']}: {answer}  ({q_time:.1f}s)")

    # 每 50 条中间落盘一次,避免中途出错丢失结果
    if (i + 1) % 50 == 0:
        json.dump(results, open(OUTPUT_FILE, "w", encoding="utf-8"), ensure_ascii=False, indent=2)

# 最终写入完整结果
json.dump(results, open(OUTPUT_FILE, "w", encoding="utf-8"), ensure_ascii=False, indent=2)

total_time = time.perf_counter() - START_TIME
print(f"完成,共 {len(results)} 条,结果保存至 {OUTPUT_FILE}")
print(f"总耗时 {total_time:.1f}s")
代码主要流程如下:
- 读取数据集,数组每个问题以{问题id, 问题, 文档}以形式放到数组中
- 读取模型和分词器
- 遍历每个问题,将问题和文档用提示词组装起来,套用对话模板
- 调用模型生成答案,解码并返回
- 将所有答案放到一个{问题id: 答案} 的map中,并保存到文件里
实际上除了处理数据的部分外,调用大模型的流程和之前【AI】大模型本地部署与量化:Ollama、transformers、llama.cpp实践文章中调用大模型的方式基本一致。
计算输出结果
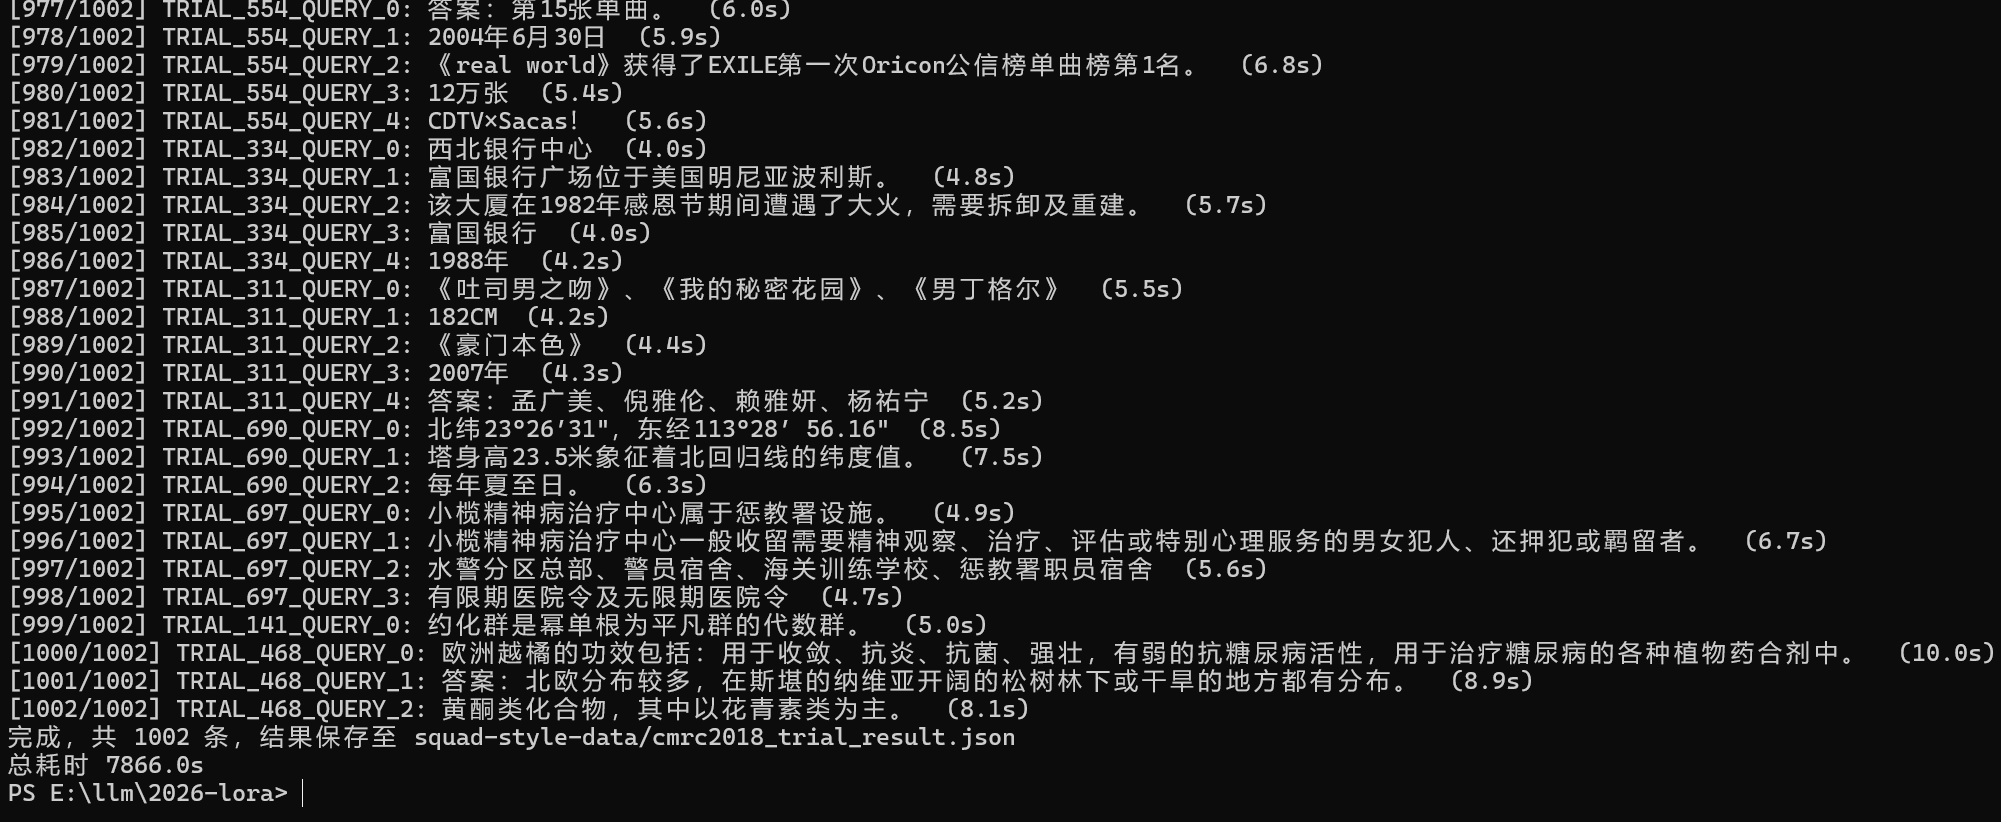
我使用纯CPU计算,经过两个多小时,终于跑完了1002条数据,此时命令行输出如下图:
然后就是通过数据集中的答案来计算评价指标了。数据集中给的cmrc2018_evaluate.py代码,是用Python2写的,在目前Python3的环境中无法执行。因此首先要将代码修改为Python3的形式,才能计算结果分数。我参考AI进行了迁移,改动后的代码我放到llm-learn-jzplp这个GitHub仓库中的2026-lora/cmrc2018_evaluate_py3.py。这里仅列出改动内容:
- Python3支持print,无需导入
- Python3的str本身就是unicode,无需设置各种编码解码
- Python3不支持
ur前缀,改为r - 打开文件改为显式指定UTF-8模式
注意nltk在Python3时还需要下载punkt,这里我执行的命令为:
pip install nltk
python -c "import nltk; nltk.download('punkt'); nltk.download('punkt_tab')"
然后执行这段Python脚本,输出的结果如下:
python cmrc2018_evaluate_py3.py cmrc2018_trial.json cmrc2018_trial_result.json
{"AVERAGE": "35.149", "F1": "54.230", "EM": "16.068", "TOTAL": 1002, "SKIP": 0, "FILE": "cmrc2018_trial_result.json"}
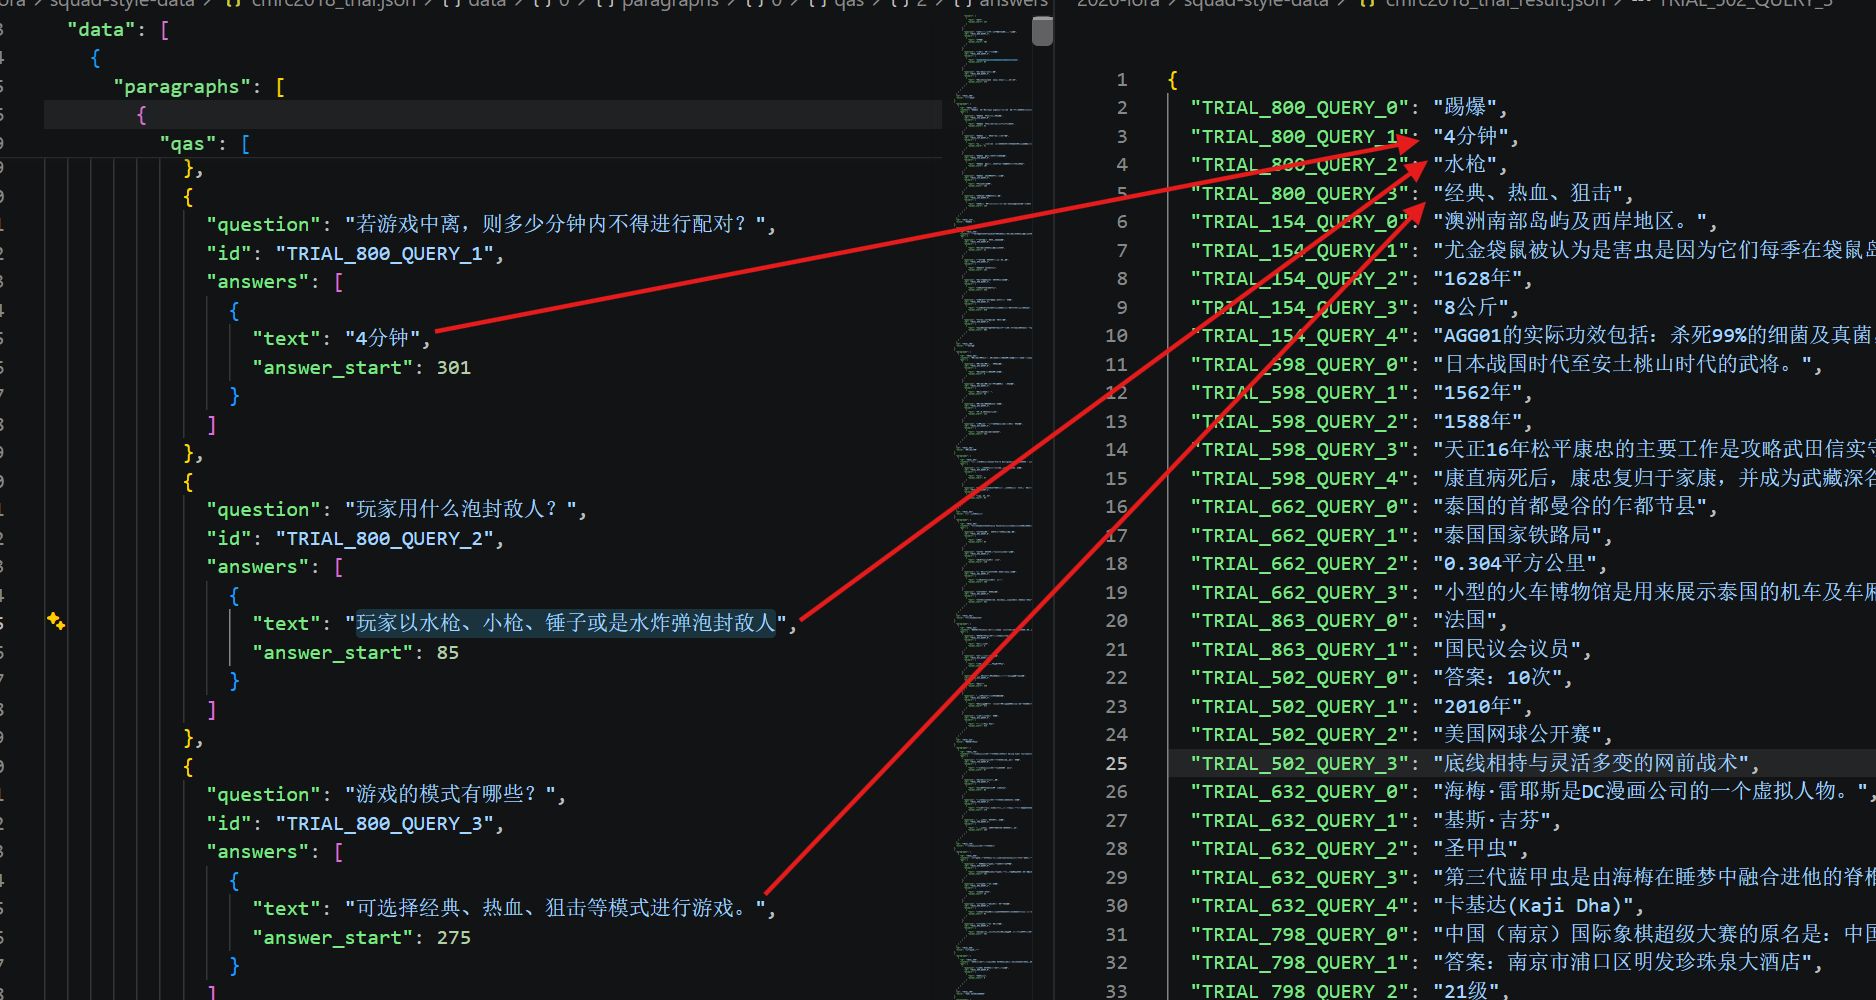
可以看到这个结果在开放挑战排名中处于比较低的位置,模型可能还是有提升空间的。这里我们对比了几个数据,可以看到部分错误答案确实是存在问题的,例如知识总结不全等,但也有一些答案意思是一致的,只不过描述有区别。
LoRA训练代码
这一节我们分步讲解训练代码的各个模块。
数据处理代码
首先是数据处理部分,是将训练和验证数据集处理成大模型训练需要的形式。这里为了方便测试和后续流程处理,这部分代码支持命令行执行和作为模块被其它文件import。
"""
读取 CMRC2018 训练数据,套入 Qwen3 对话模板,生成 torch 训练输入数据

用法一(命令行预览):
    python prepare_data.py               # 读取全部数据并预览训练集第 1 条
    python prepare_data.py --split val   # 读取全部数据并预览验证集第 1 条

用法二(被其他脚本 import):
    from prepare_data import prepareData
    train_dataset, val_dataset, tokenizer = prepareData()
    train_dataset, val_dataset, tokenizer = prepareData(limit=5, val_limit=10)

每条样本含 input_ids / labels,无 padding;打乱由 Trainer 负责
"""
import argparse
import json

import torch
from torch.utils.data import Dataset
from transformers import AutoTokenizer

# 训练数据文件
TRAIN_JSON = "squad-style-data/cmrc2018_train.json"
# 验证数据文件
VAL_JSON = "squad-style-data/cmrc2018_trial.json"
# 模型目录
MODEL_DIR = "Qwen3-0.6B-train"

def load_examples(path):
    """读取 SQuAD 格式 json,返回 (上下文, 问题, 答案) 的列表。"""
    with open(path, "r", encoding="utf-8") as f:
        raw = json.load(f)

    examples = []
    for article in raw["data"]:
        for para in article["paragraphs"]:
            for qa in para["qas"]:
                answers = qa.get("answers") or []
                if answers:
                    examples.append(
                        (para["context"], qa["question"], answers[0]["text"])
                    )
    return examples

def build_prompt(question, context):
    return [
        {
            "role": "user",
            "content": (
                "请阅读下面的材料,回答问题。"
                "答案必须来自材料原文,直接输出答案文本,不要输出其他任何内容。\n\n"
                f"材料:{context}\n\n问题:{question}\n答案:"
            ),
        }
    ]

def encode(example, tokenizer):
    """把一条问答转成训练用的 {input_ids, labels}。"""
    context, question, answer = example

    # 第 1 步:组合字符串模板(材料 + 问题)
    user_messages = build_prompt(question, context)

    # 第 2 步:用模板生成非答案部分(user + assistant 起始符)并直接分词
    #   tokenize=True               直接输出 token id 列表
    #   add_generation_prompt=True  追加 assistant 起始符,即模型开始生成答案的位置
    #   enable_thinking=False       关闭思考模式
    #   add_special_tokens=False    模板里已含特殊符号,不能让 tokenizer 再加 BOS/EOS
    prompt_ids = tokenizer.apply_chat_template(
        user_messages,
        tokenize=True,
        add_generation_prompt=True,
        enable_thinking=False,
        add_special_tokens=False,
    )["input_ids"]

    # 第 3 步:答案直接分词,末尾补 eos(<|im_end|>,id=151645),让模型学会停止
    answer_ids = tokenizer(answer, add_special_tokens=False)["input_ids"]
    answer_ids = answer_ids + [tokenizer.eos_token_id]

    # 第 4 步:拼接成完整输入,前段是问题(不算 loss),后段是答案(算 loss)
    input_ids = prompt_ids + answer_ids
    labels = [-100] * len(prompt_ids) + answer_ids

    # 第 5 步:转 tensor
    #   dtype=torch.long   token id 必须是 int64
    return {
        "input_ids": torch.tensor(input_ids, dtype=torch.long),
        "labels": torch.tensor(labels, dtype=torch.long),
    }


class QADataset(Dataset):
    """包装样本列表,提供 PyTorch Dataset 接口,可直接交给 Trainer。"""

    def __init__(self, samples):
        self.samples = samples

    def __len__(self):
        return len(self.samples)

    def __getitem__(self, idx):
        return self.samples[idx]


def build_dataset(path, tokenizer, limit=0):
    """读取指定 json 并预处理成 QADataset,训练集/验证集共用。"""
    examples = load_examples(path)
    if limit > 0:
        examples = examples[:limit]
    return QADataset([encode(ex, tokenizer) for ex in examples])


def prepareData(limit=0, val_limit=0):
    """读取训练集和验证集并完成预处理,返回 (Dataset, Dataset, tokenizer)。

    train_dataset: 训练集,每条含 input_ids / labels
    val_dataset:   验证集,同样含 input_ids / labels
    tokenizer:     两边共用同一份分词器
    """
    tokenizer = AutoTokenizer.from_pretrained(MODEL_DIR)

    train_dataset = build_dataset(TRAIN_JSON, tokenizer, limit)
    val_dataset = build_dataset(VAL_JSON, tokenizer, val_limit)
    return train_dataset, val_dataset, tokenizer


def main():
    """命令行脚本入口:读取全部数据,预览指定数据集的第 1 条样本。"""
    parser = argparse.ArgumentParser(description="预览 CMRC2018 预处理结果")
    parser.add_argument(
        "--split",
        choices=["train", "val"],
        default="train",
        help="预览训练集还是验证集(默认 train)",
    )
    args = parser.parse_args()

    train_dataset, val_dataset, tokenizer = prepareData()
    dataset = train_dataset if args.split == "train" else val_dataset

    print(f"训练集:{len(train_dataset)} 条,验证集:{len(val_dataset)} 条")

    sample = dataset[0]
    print("\n=== 第 1 条样本 ===")
    for k, v in sample.items():
        print(f"{k}: shape={tuple(v.shape)}, dtype={v.dtype}")

    prompt_len = int((sample["labels"] == -100).sum())
    total_len = sample["input_ids"].shape[0]
    print(f"prompt tokens = {prompt_len}, answer tokens = {total_len - prompt_len}")
    print("input_ids 解码(完整):")
    print(tokenizer.decode(sample["input_ids"], skip_special_tokens=True))
    print("labels 解码(仅答案):")
    answer_ids = sample["labels"][sample["labels"] != -100].tolist()
    print(tokenizer.decode(answer_ids, skip_special_tokens=False))

# 命令行调用入口
if __name__ == "__main__":
    main()
简要描述一下数据处理流程,由于我们的训练与验证数据只有一万条和一千条,因此我们将数据整个读到内存备用。
- 首先读取训练和验证数据文件,处理成(上下文, 问题, 答案)的列表。
- 材料和问题套入Qwen3对话模板,生成tokenId列表。
- 答案部分单独分词,并在最后加入结束标记,生成tokenId列表。
- 将问题和答案的tokenId列表合并,同时生成labels数组。
- 转成PyTorch的张量形式。
- 创建QADataset类继承Dataset,将数组封装进内部。这是后面训练工具需要的格式。
- 模块形式返回数据;命令行形式则输出数据统计和第一个例子。
注意对于问答数据的训练,只有答案部分的预测计算loss和进行反向传播,问题和材料部分只作为答案预测的上下文。因此labels就是用来控制哪些位置是计算loss的,计算loss时参考的“正确答案”是啥。其中不计算loss的位置设置固定值-100;计算loss的位置赋值对应位置的tokenId。
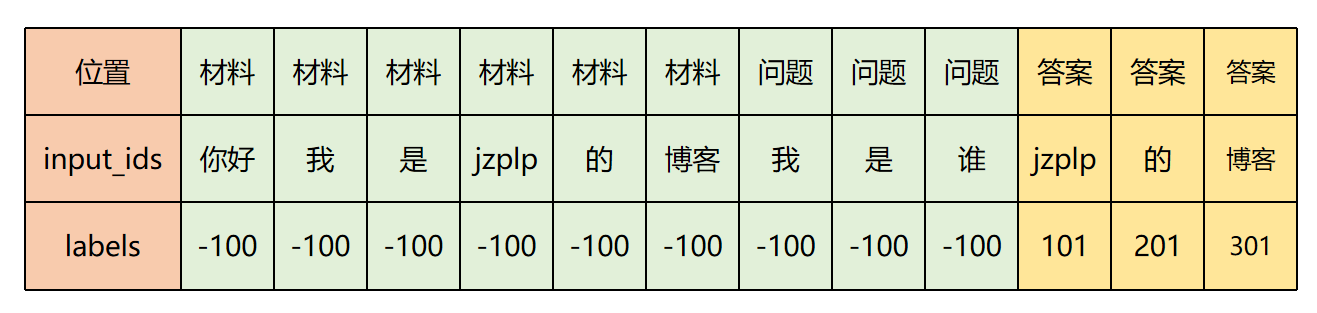
这里有人会好奇,labels是不是只有-100有意义。因为计算loss的位置的tokenId值,可以从input_ids里面拿到,不需要这里再赋值一遍。对于当前任务的大模型场景,确实这里只有-100有意义。但对于其它非大模型任务,例如部分翻译/改写时,存在输入token A,正确输出是token B的不一样的场景,此时B的值就应该放到labels中。
训练代码
然后就是真正的LoRA训练代码了。由于这里我们使用的是标准的LoRA方法和标准的训练流程,因此可以直接使用训练工具,无需自己编写训练流程代码。这里LoRA使用peft,训练流程使用Trainer。
"""
用 LoRA 微调 Qwen3-0.6B
用法:
    python train_lora.py  # 全量训练集 + 全量验证集
    python train_lora.py --limit 100 --val_limit 50  # 训练集只用前100条,验证集前50条
    python train_lora.py --resume Qwen3-0.6B-lora/checkpoint-200  # 从指定 checkpoint 继续训练
"""
import argparse

import torch
from peft import LoraConfig, TaskType, get_peft_model
from transformers import AutoModelForCausalLM, Trainer, TrainingArguments

# 模型目录与数据预处理函数复用 prepare_data.py
from prepare_data import MODEL_DIR, prepareData

# LoRA 权重输出目录(只保存适配器,不包含基座模型)
OUTPUT_DIR = "Qwen3-0.6B-lora"


def build_model():
    """加载模型,并用 peft 给它挂上 LoRA 适配器。"""
    # CPU 训练统一使用 fp32(原始权重是 bf16,这里会转换成 fp32)
    model = AutoModelForCausalLM.from_pretrained(
        MODEL_DIR,
        dtype=torch.float32,
    )
    # 训练时关闭 KV cache:它只用于生成加速,训练阶段用不到
    model.config.use_cache = False

    # LoRA 配置:冻结原模型参数,只在指定线性层旁加可训练的低秩矩阵
    lora_config = LoraConfig(
        task_type=TaskType.CAUSAL_LM,  # 因果语言模型任务
        r=8,  # LoRA 秩,越大可训练参数越多、表达能力越强
        lora_alpha=16,  # 缩放系数,实际缩放为 alpha / r,通常取 2*r
        bias="none",  # 不训练 bias
        # 作用在 Qwen3 注意力层的 q/k/v/o 投影矩阵上
        target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
    )
    # get_peft_model 会冻结基座参数,只保留 LoRA 参数可训练
    model = get_peft_model(model, lora_config)
    # 打印可训练参数量及占比,便于确认 LoRA 是否挂载成功
    model.print_trainable_parameters()
    return model


def main():
    # 命令行参数:训练集/验证集条数限制
    parser = argparse.ArgumentParser()
    parser.add_argument("--limit", type=int, default=0, help="训练集只取前 N 条(0=全部)")
    parser.add_argument("--val_limit", type=int, default=0, help="验证集只取前 N 条(0=全部)")
    parser.add_argument(
        "--resume",
        type=str,
        default=None,
        help="从指定 checkpoint 目录继续训练,例如 Qwen3-0.6B-lora/checkpoint-200",
    )
    args = parser.parse_args()

    # 复用 prepare_data.py:返回训练集、验证集,已套好 Qwen3 模板,prompt 部分的 labels 为 -100
    train_dataset, val_dataset, _ = prepareData(args.limit, args.val_limit)
    print(f"训练样本数: {len(train_dataset)},验证样本数: {len(val_dataset)}")

    # 加载模型并挂 LoRA
    model = build_model()

    # 按 3 个 epoch 的总优化步数计算 3% 预热步数
    steps_per_epoch = max(len(train_dataset) // 16, 1)
    warmup_steps = int(steps_per_epoch * 3 * 0.03)

    # TrainingArguments 只是训练配置容器,由 Trainer 读取后执行
    training_args = TrainingArguments(
        output_dir=OUTPUT_DIR,  # checkpoint 和最终权重保存目录
        per_device_train_batch_size=1,  # batch size,与 prepare_data 一致
        gradient_accumulation_steps=16,  # 累积 16 步再更新,等效增大 batch
        num_train_epochs=3,  # 训练轮数
        learning_rate=2e-4,  # LoRA 参数学习率,通常比全参微调大
        lr_scheduler_type="cosine",  # 余弦退火学习率
        warmup_steps=warmup_steps,  # 前 3% 步数线性预热
        logging_steps=10,  # 每 10 步打印一次 loss
        save_strategy="steps",  # 按步数保存 checkpoint
        save_steps=10,  # 每 10 步保存一次
        save_total_limit=2,  # 最多保留 2 个 checkpoint
        eval_strategy="steps",  # 按步数计算 val loss
        eval_steps=200,  # 每 200 步验证一次
        per_device_eval_batch_size=1,  # 验证 batch size
        dataloader_pin_memory=False,  # CPU 训练没有加速器,关闭 pin memory
        optim="adamw_torch",  # 使用 PyTorch 原生 AdamW
        report_to="none",  # 不上报 wandb 等平台
        seed=42,  # 随机种子,保证可复现
    )

    # Trainer 负责:按批读取数据、优化器、学习率调度、日志、保存等训练流程
    trainer = Trainer(
        model=model,
        args=training_args,
        train_dataset=train_dataset,
        eval_dataset=val_dataset,
    )

    # 开始训练;args.resume 为 None 时从头开始
    trainer.train(resume_from_checkpoint=args.resume)

    # 只保存 LoRA 适配器(几十 MB),不保存整个模型和分词器
    trainer.save_model(OUTPUT_DIR)
    # 保存训练状态(含 log_history)到 trainer_state.json
    trainer.save_state()

    print(f"LoRA 适配器已保存到: {OUTPUT_DIR}")
    print(f"训练日志已保存到: {OUTPUT_DIR}/trainer_state.json")

if __name__ == "__main__":
    main()
可以看到,通过使用预设好的训练工具,训练代码本身是非常简洁的。简要描述一下代码执行流程:
- 使用前面写好的输出处理模块prepareData获取训练集验证集数据。
- 加载基座模型本身,使用peft创建LoRA配置并挂载在模型上。
- 使用TrainingArguments创建训练配置,使用Trainer进行训练。
- 训练完成后保存模型和训练中的状态日志。
由于我使用的电脑CPU训练且内存只有16GB,batch只能设为1,因此省下了部分创建batch的操作。即使内存足够的情况下,由于训练数据长度不一致,增大batch size需要将每个batch中的数据按照最大长度统一对齐。中间增加的是无效token,但也会经过大模型计算后再丢弃,因此造成很多无效计算。例如下图中的蓝色区域,其中mask为0表示屏蔽模型中的注意力计算。
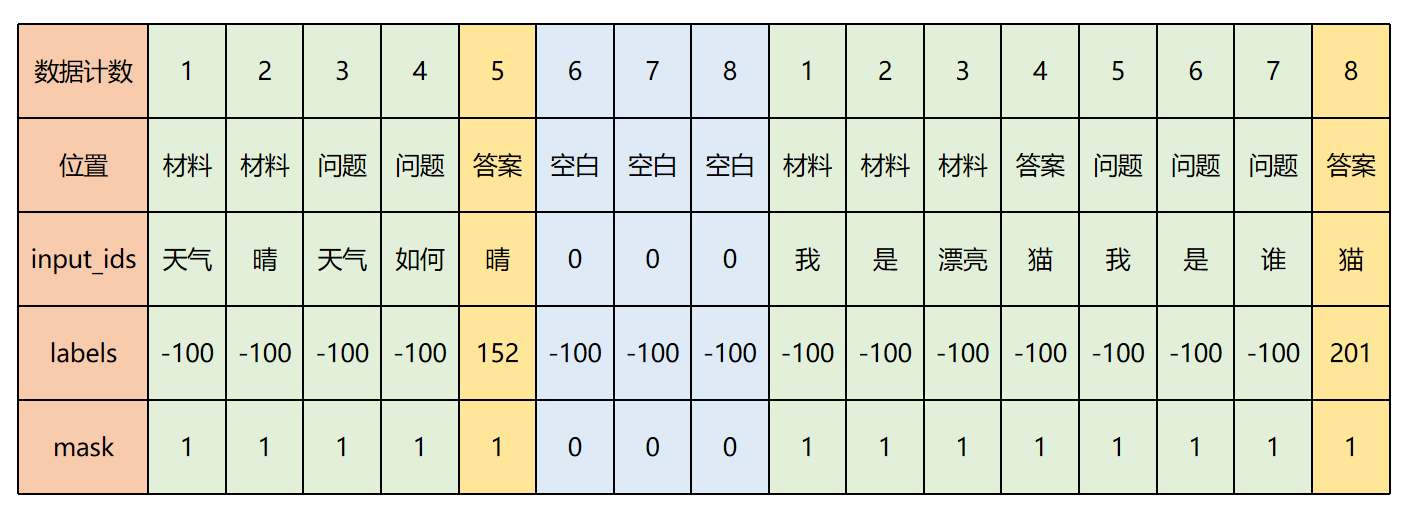
在使用GPU的情况下(只要没有达到算力限制)可以做到并行处理,无效计算不会额外耗时,因此batch size增大可以提高效率,减少训练时间。但由于CPU核心数少,并行计算能力不强,batch size增大确实会减小内存重复读取模型参数,略微减轻一点训练时间,但可能还没有无效计算带来的时间增长更大。因此CPU场景下batch size为1是合适的。
但为了模仿batch size的场景,使用gradient_accumulation_steps参数,设置为16。作用为将每个数据训练后的梯度除以16再加到梯度值上,经过16个训练数据后,将现有的梯度值做一次参数更新,然后将保存的梯度值清零。通过这种方式,可以在batch size=1的场景下,获取和batch size=16一样的参数更新训练效果。后面我们将gradient_accumulation_steps参数* batch size值作为1步,也就是一次参数更新。
注意虽然原模型是bf16,但这里我们使用fp32进行训练。这是因为我门使用CPU对bf16的支持程度不全,还不如计算fp32速度更快。
训练参数更新方式和之前了解过的方式基本一致,例如使用Warmup + Cosine Decay作为学习率调度器,使用AdamW作为梯度下降优化器的之前,本次还用到了Trainer的一些实用的功能:
- 自动跑验证集,计算val loss。这里设置了每200步自动计算一次,不需要我们手动计算
- 每10步保存一次当前训练结果checkpoint到硬盘中,最多同时保存两份。这样当我们暂停训练后,可以通过指定checkpoint恢复训练进度,最多损失10步的训练时间。
- 每10步打印一次日志,包含当前训练进度和loss等数据。同时在训练结束后也会把所有中间日志保存下来。
小样本试跑
跑完整个训练过程需要很长时间,因此我们设置了命令行参数,可以使用很少的数据集先运行一下训练代码试试,不然有些低级错误等训练了很久才会暴露,这样非常耽误时间。
我设置了训练集数据量100,验证集数据量50,gradient_accumulation_steps为4,每跑完一个epoch计算一次val loss。然后试着跑了训练代码,命令行输出如下图:
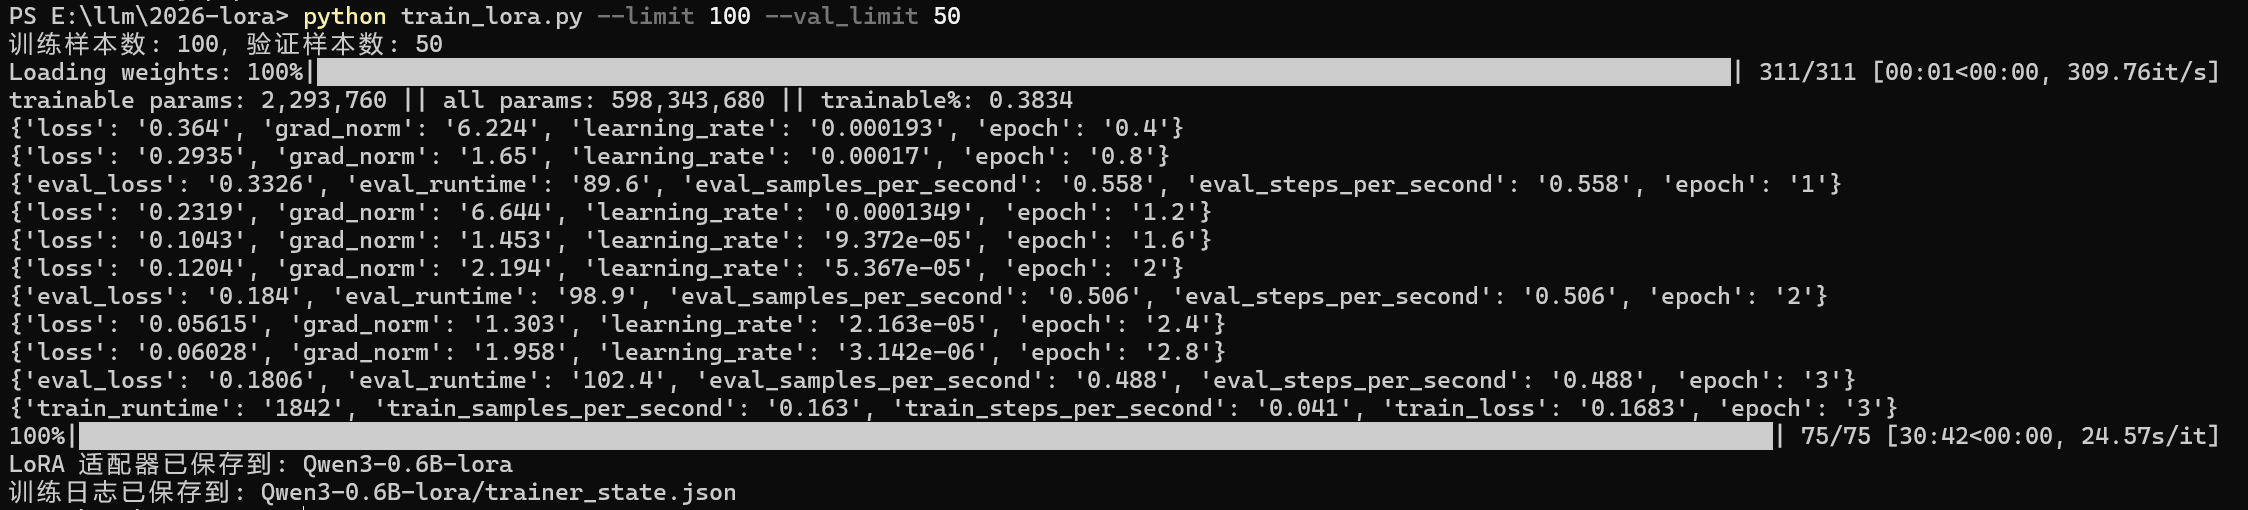
我们一个一个解释一下这些输出的含义。首先是最上面的部分:
- trainable params: 2,293,760 表示可训练参数的数量
- grad_norm: 598,343,680 模型总参数数量
- trainable%: 0.3834 可训练参数的占比 0.38%
中间部分是训练集和验证集的输出日志。首先是训练集日志:
- loss: 当前10步的训练集平均loss值
- grad_norm : 当前步的所有可训练参数梯度的整体大小
- learning_rate: 当前步的学习率
- epoch: 当前步在epoch中的进度比例
然后是验证集日志:
- eval_loss: 验证集平均loss
- eval_runtime: 本次验证总耗时秒数
- eval_samples_per_second: 每秒处理的数据条数
- eval_steps_per_second: 每秒处理的数据步数,这里和条数相同
- epoch: 验证发生时的训练进度
看最下面右侧,75表示总步数为75步,实际为100条数据集*epoch为3再除以每步的问题数4=75。训练代码执行了30分钟42秒,其中一步的训练时间为24.57秒。那么平均一个问题的训练时间为24.57/4≈6.1秒。
在训练结束后,在输出目录中会生成一些文件,如下图。其中以 checkpoint-* 命名的子目录是训练中为了暂停恢复保存的checkpoint,其中*表示当前为多少步。而外面为模型训练完成后保存的模型文件。注意我们这里只保存了LoRA新增的模块,并没有将这部分拼回模型,因此文件大小非常小,checkpoint目录总共有几十MB,训练完的模型则只有10MB左右。下面介绍一下这些文件的含义:
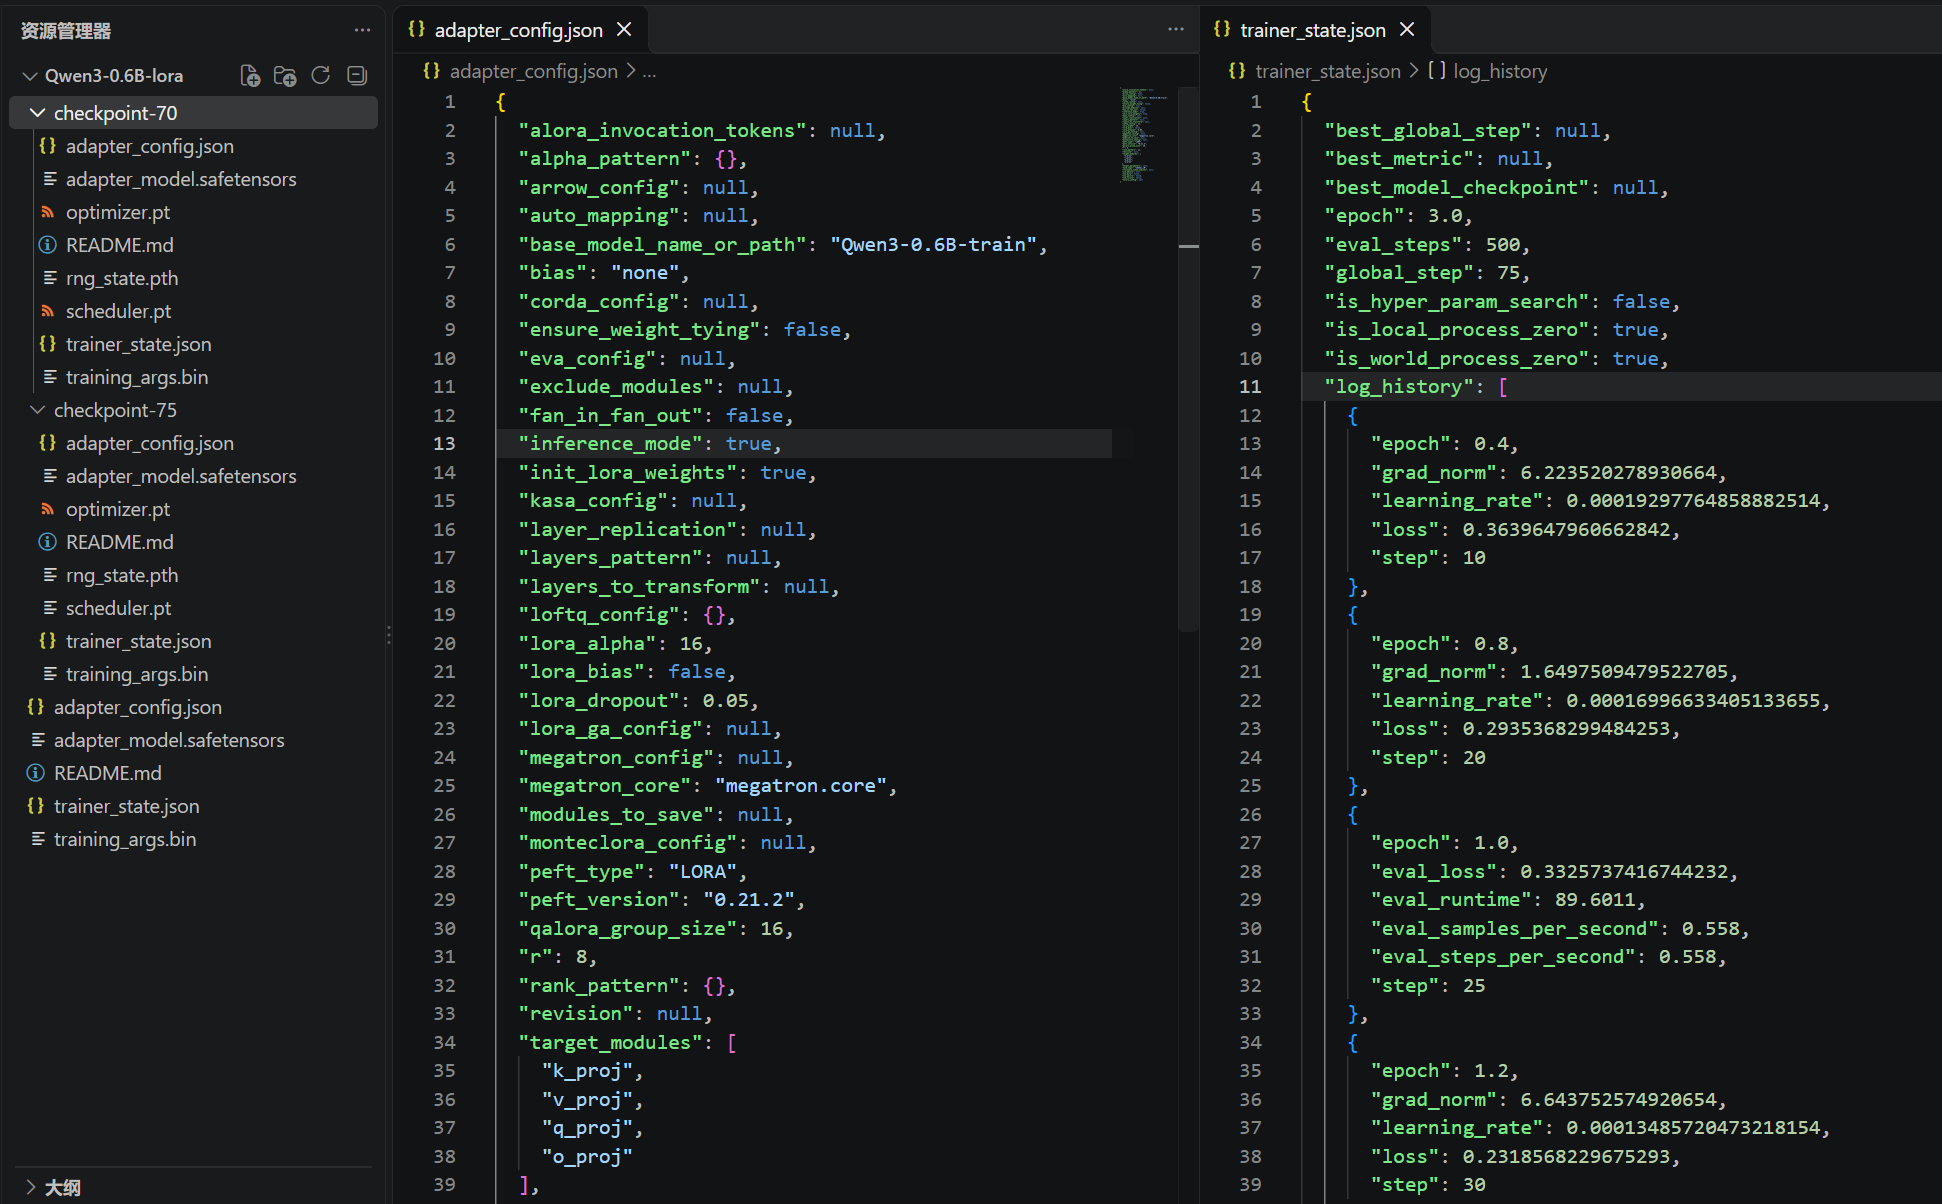
下面介绍一下这些文件的含义。首先是训练完成后保存的模型文件:
- adapter_model.safetensors 训练完成的LoRA参数值
- adapter_config.json LoRA配置,包含r, lora_alpha等,有它才能将LoRA挂回原模型
- training_args.bin 训练参数TrainingArguments的记录,为二进制格式
- trainer_state.json 训练日志,训练中打印在屏幕上的日志全部包含于此
然后是训练中保存的checkpoint目录内容:
- adapter_model.safetensors 当前训练的LoRA参数值
- adapter_config.json LoRA配置
- optimizer.pt AdamW优化器状态
- scheduler.pt 学习率调度器状态
- rng_state.pth 随机数状态,用于恢复后保持顺序等一致
- training_args.bin 训练参数TrainingArguments的记录,为二进制格式
- trainer_state.json 当前训练日志,训练中打印在屏幕上的日志全部包含于此
可以看到,训练完成后的模型文件内容,checkpoint目录中是都有的。因此即使checkpoint没有训练完成,也可以使用它作为正常模型输出使用。而且由于checkpoint是在训练在进行中,因此里面会有一些模型训练的中间状态保存。
模型使用与合并
训练之后的基座模型和LoRA模块部分是分开的,那么应该如何运行这个“新模型”呢?事实上非常简单,LoRA部分使用PeftModel加载,然后和原模型组合即可。注意不能使用device_map="auto",使用了可能会修改到基座模型文件,表现为后面合并模型时会出错。
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import PeftModel

# 原模型(基座模型)路径
MODEL_NAME = "Qwen3-0.6B-train"
# LoRA 权重路径
LORA_PATH = "Qwen3-0.6B-lora"

# 加载分词器(LoRA 目录不含分词器,使用基座模型的分词器)
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
# 加载基座模型
base_model = AutoModelForCausalLM.from_pretrained(
    MODEL_NAME, torch_dtype="auto"
)
# 在基座模型上加载 LoRA 适配器,得到微调后的模型
model = PeftModel.from_pretrained(base_model, LORA_PATH)
后面的代码和之前模型测试部分的代码一模一样,使用模型做推理的方式没有任何变化。这样外挂的方式数据存储量小,假设有多个外挂模块时,不需要重复存储基座模型参数,使用也非常方便。注意到虽然基座模型是bf16,LoRA模块是fp32,但peft会将LoRA模块的精度格式自动转换为基座模型的格式,因此我们不用担心不配套而报错。同时我们训练出的LoRA模块也可以和原模型合并,成为一个完整的模型:
"""
将基座模型与 LoRA 权重合并为一个完整模型,并同时保存分词器
用法:
    python merge_lora.py
"""
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer

# 原模型(基座模型)路径
BASE_MODEL_PATH = "Qwen3-0.6B-train"
# LoRA 权重路径
LORA_PATH = "Qwen3-0.6B-lora"
# 合并后完整模型的输出路径
OUTPUT_DIR = "Qwen3-0.6B-merged"


def main():
    # 加载分词器(LoRA 目录不含分词器,使用基座模型的分词器)
    tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL_PATH)
    # 加载基座模型,dtype 与原始权重保持一致
    base_model = AutoModelForCausalLM.from_pretrained(
        BASE_MODEL_PATH, torch_dtype="auto"
    )
    # 在基座模型上加载 LoRA 适配器
    model = PeftModel.from_pretrained(base_model, LORA_PATH)
    # 把 LoRA 权重合并进基座权重,并移除适配器结构,得到普通模型
    model = model.merge_and_unload()
    # 推理模式,关闭 dropout
    model.eval()

    # 保存合并后的完整模型
    model.save_pretrained(OUTPUT_DIR)
    # 同时保存分词器
    tokenizer.save_pretrained(OUTPUT_DIR)
    print(f"合并完成,完整模型与分词器已保存到: {OUTPUT_DIR}")


if __name__ == "__main__":
    main()
可以看到合并也非常简单,注意这里要把分词器也一起放到新模型目录中,否则每次还要从原目录中拿分词器。合并完成后新模型的格式和使用方式就和原模型完全一样了。
自定义早停功能
看是否需要 先不做
实验设计和结果
训练实验设计
在描述实验设计之前,首先描述一下我的客观条件,即硬件配置。目前暂时我没有显卡,是使用CPU跑实验的,具体配置如下:
- CPU Intel i5-14500 14核20线程
- 内存 DDR4 3200 16GB
由于CPU核心数少,算力低,训练时间太久,跑一次实验可能要2-3天,因此只尝试较少的实验组合。下面我们来介绍实验设计:
- 尝试LoRA的不同R值。LoRA中的R值是最重要的参数,R值越大,矩阵可以表示更复杂的变化,对模型的修改能力越强。同时训练的时间也会越长。但R值太高时,效果提升可能也不大。
- 尝试不同的提示词。注意我们将材料和问题属于模型时,首先用对话模板将他拼接起来,其中包含了简单的提示词。不同的提示词对模型的效果可能不同,我们将尝试不同对话模板在训练前,训练后对模型的实验效果。
- 尝试打开和关闭思考模式。虽然看起来CMRC2018这个任务和思考模式没有任何关系,但模型对于材料和问题的额外思考是否对于结果有帮助,这是我们想要验证的。
最终我们尝试了下面这些实验组合:
| 实验序号 | LoRA的r值 | 思考模式 | 提示词 |
|---|---|---|---|
| 1 | 8 | 关 | 提示词1 |
| 2 | 16 | 关 | 提示词1 |
| 3 | 32 | 关 | 提示词1 |
| 4 | 64 | 关 | 提示词1 |
| 5 | 16 | 开 | 提示词1 |
| 6 | 16 | 关 | 模板2 |
| 7 | 16 | 关 | 模板3 |
三种提示词的对话模板数据如下:
实验结果
总结
- 还有很多在LoRA基础上改进的方法
- https://github.com/jzplp/llm-learn-jzplp 这个仓库中有相关代码
参考
- 【AI】一文读懂大模型生态:分类/参数/结构/训练/GPU/评测/排行/社区
https://jzplp.github.io/2026/llm-stru.html - 【AI】大模型本地部署与量化:Ollama、transformers、llama.cpp实践
https://jzplp.github.io/2026/llm-deploy.html -【AI】大模型参数训练原理:Softmax/损失函数交叉熵/反向传播/梯度下降优化器/学习率调度器/训练数据划分
https://jzplp.github.io/2026/llm-param.html - LoRA这种微调方法和全参数比起来有什么劣势吗?
https://www.zhihu.com/question/608674675 - LoRA: Low-Rank Adaptation of Large Language Models
https://arxiv.org/abs/2106.09685 - LoRA论文对应代码
https://github.com/microsoft/LoRA - 图解大模型微调系列之:大模型低秩适配器LoRA(原理篇)
https://zhuanlan.zhihu.com/p/646831196 - 图解 Fine-tuning:LoRA 系列微调技术概述
https://zhuanlan.zhihu.com/p/990958034 - GitHub CMRC 2018
https://github.com/ymcui/cmrc2018 - CMRC 2018 开放挑战排名
https://ymcui.com/cmrc2018/ - 第二届“讯飞杯”中文机器阅读理解评测 (CMRC 2018)
https://hfl-rc.github.io/cmrc2018/ - Cui, Y., Liu, T., Che, W., Xiao, L., Chen, Z., Ma, W., Wang, S., & Hu, G. (2019). A span-extraction dataset for Chinese machine reading comprehension. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP) (pp. 5886–5891). Association for Computational Linguistics.
https://aclanthology.org/D19-1600/ - GitHub llm-learn-jzplp
https://github.com/jzplp/llm-learn-jzplp